VIDEO · 2026
命中率翻倍:Jev 给 RAG 当裁判
一支约 7 分钟的实测视频,附完整图文。Jev 该插在 RAG 的哪一步?我用 TypeSafe 官方文档搭了小 RAG,手写 36 道英文题实测:重排后第一名从 7 道到 17 道,近失和无关的题全部拦住,也讲清它做不到什么。
中文旁白 · 720p · 字幕轨道 · MP4
文章:Jev 给 RAG 当裁判:第一名从 7 道到 17 道
Jev 是 TypeSafe 公司 2026 年 9 月发布的一个决策模型,官方叫它 System One 模型。你给它一段状态(文本或 JSON),再给几个带类型的问题,比如多选、打分、是非题,它返回每个选项的概率。它不生成文字,只做判断。
这两周,X 上有不少人说 Jev 很适合做 RAG。RAG 是一种常见的做法:先从资料库里找出几段文字,再交给大模型照着回答。有人说 Jev 解决了 RAG 的精度问题,但大多数帖子没有给数据。我更想知道一个具体的问题:Jev 到底该插在 RAG 的哪一步。
所以我用 TypeSafe 自己的官方文档搭了一个小 RAG,手写了一批问题,测了一下。这篇文章先讲 RAG 为什么会答错,再整理 X 上的几种说法。然后我会交代实验的方法、条件和结果。最后讲 Jev 该放在哪里,以及它做不到什么。
一、RAG 为什么会答错
RAG 里有两个角色。检索负责从资料库里找出和问题相关的几段文字,大模型负责读这几段,再写出回答。检索一般按相似度排序。一种看字面,数问题和段落有多少词重合。另一种是向量检索,它把每段文字变成一串数字,比较这些数字有多接近,所以换了说法的句子也能找到。
问题在于,相似不等于能回答。假设用户问「退货要几天?」,检索可能送来三段:退货政策、退货流程说明、年会通知。退货政策里写了天数。退货流程说明讲的是怎么寄回,看着很像,但没写天数。年会通知里也许碰巧出现了几个相同的词,同样没写答案。
大模型拿到这三段,并不知道哪一段真的有答案。如果写了答案的那段根本没被检索上来,它往往会照着手里无关的段落,编一个看起来很像样的回答。这种错比直接说「不知道」更麻烦,因为读的人很难看出来。
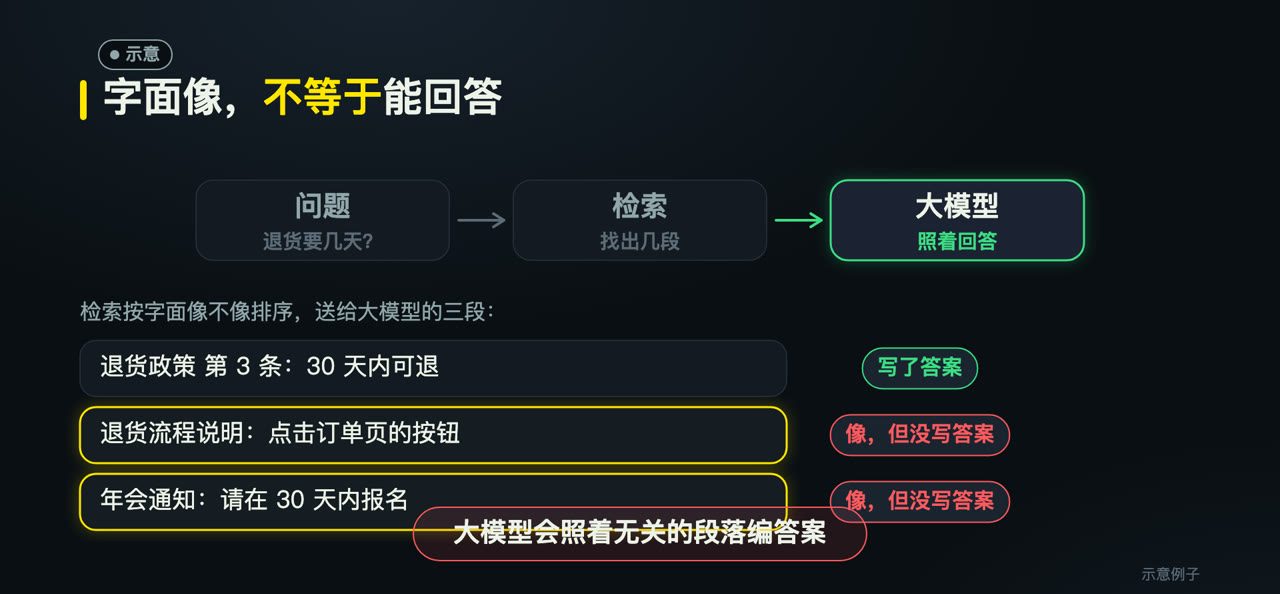
所以 RAG 答错,大致有两种情况。一种是检索找错了资料,答案那段排得太靠后,或者根本没找到。另一种是资料里本来就没有答案,大模型却硬答。后面的实验,就是分别看 Jev 对这两种错能做什么。
二、X 上的几种说法
9 月中下旬,X 上出现了一批「Jev 做 RAG」的帖子。我挑了三条有代表性的,下面的赞数都是我在 9 月 27 日抓取的。
点赞最多的一条是 Kush 在 9 月 17 日发的,有 2027 个赞、11.5 万浏览。他说 Jev 解决了 RAG 的精度,做法是给每个段落打分,把无关的删掉。这个思路本身没问题,但帖子里没有任何实验数据。
第二条来自 LangChain 的工程师 Viv,9 月 23 日发布,有 748 个赞、12.9 万浏览、946 个收藏。LangChain 是一个很多人用来搭 RAG 的开源框架。Viv 的建议分两种情况。资料少的时候,直接让 Jev 对每一对(问题, 文档)打分,把分数当相关度,连向量库都不用。
资料多的时候,Viv 建议先用 BM25 或向量检索召回一批,再让 Jev 重排。BM25 是一种老牌的关键词检索,只看问题和段落有多少词重合,越稀有的词权重越高。重排的意思是:先用便宜的方法捞一批候选,再用更准的方法把这批候选重新排一次顺序。回帖里有人指出,Jev 一次能考虑的选项数有上限,所以候选不能无限多。
第三条是一篇技术博客的实测,发布于 9 月 20 日,用的是 jev-1.13.0。作者自己造了一份公司规章,切成 400 段。在那篇博客的实验里,向量检索已经把答案放进了前 5,所以各家重排的精度几乎分不出高下。作者自己也承认,语料太小了。
真正拉开差距的是另一件事:「这一段能不能回答问题」。那篇博客测的是话题对、但答案没写的问题。在这类问题上,Jev 判断的正确率是 99.2%。Cohere 是另一家提供重排模型的公司,它的 Rerank 3.5 用分数卡一条线,正确率只有 65%。成本方面,那篇博客测的是 Jev 每千次 0.25 美元,Cohere 每千次 2.00 美元。
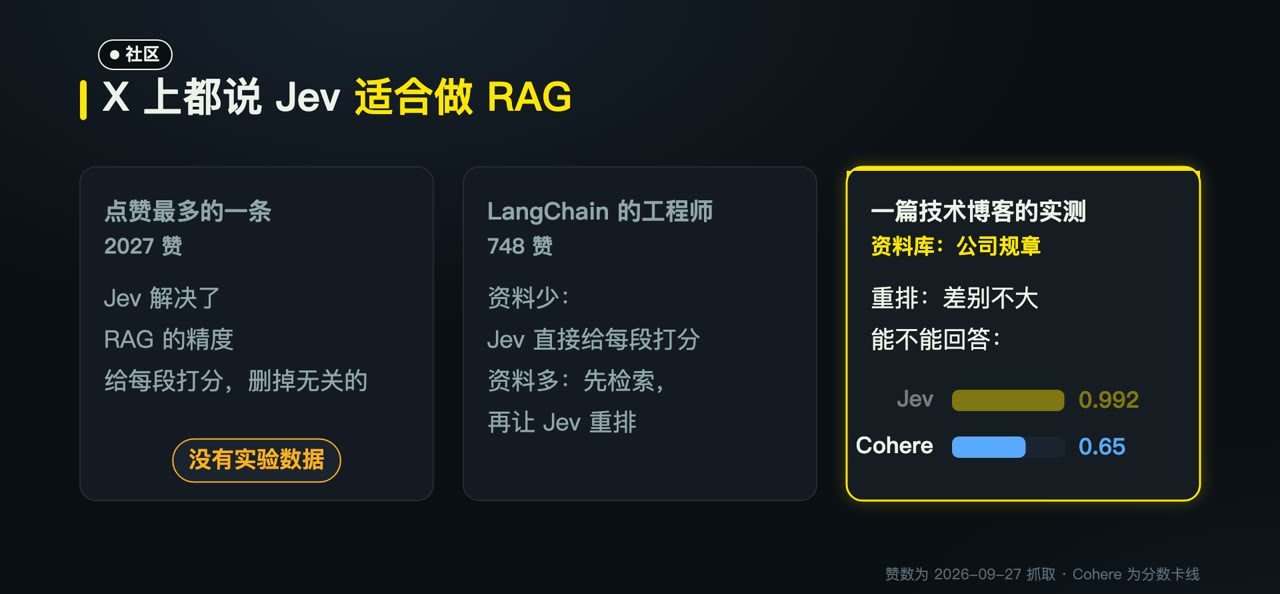
把三条放在一起看,Kush 给的是直觉,Viv 给的是位置,博客给了数据,但语料太小。我想自己测一次,而且想把「重排」和「能不能回答」分开来看。
三、我怎么测的
实验是我在 2026 年 9 月 27 日跑的,模型版本是 jev-1.13.0。代码和结果都放在 GitHub 上:github.com/DDnim/jev-rag-bench。
资料库用的是 TypeSafe 自己的官方文档,一共 42 页。我按二级小标题把它切成 258 段,去掉了代码块。选这份文档,是因为它公开,谁都可以拿去复现。
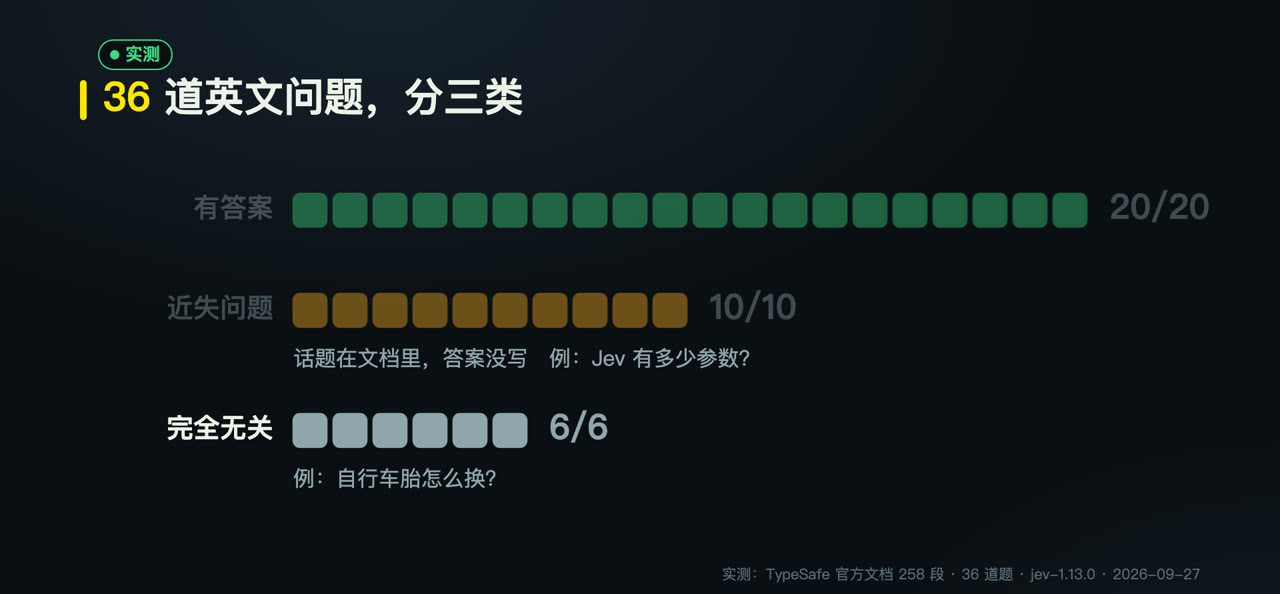
问题是我手写的 36 道英文题,分成三类:
- 有答案的题 20 道,文档里写了答案,我给每道题标好了哪几段是答案。
- 近失问题 10 道,话题在文档里出现过,但答案文档里没写。
- 完全无关的题 6 道,比如怎么换自行车胎、澳大利亚的首都是哪里。
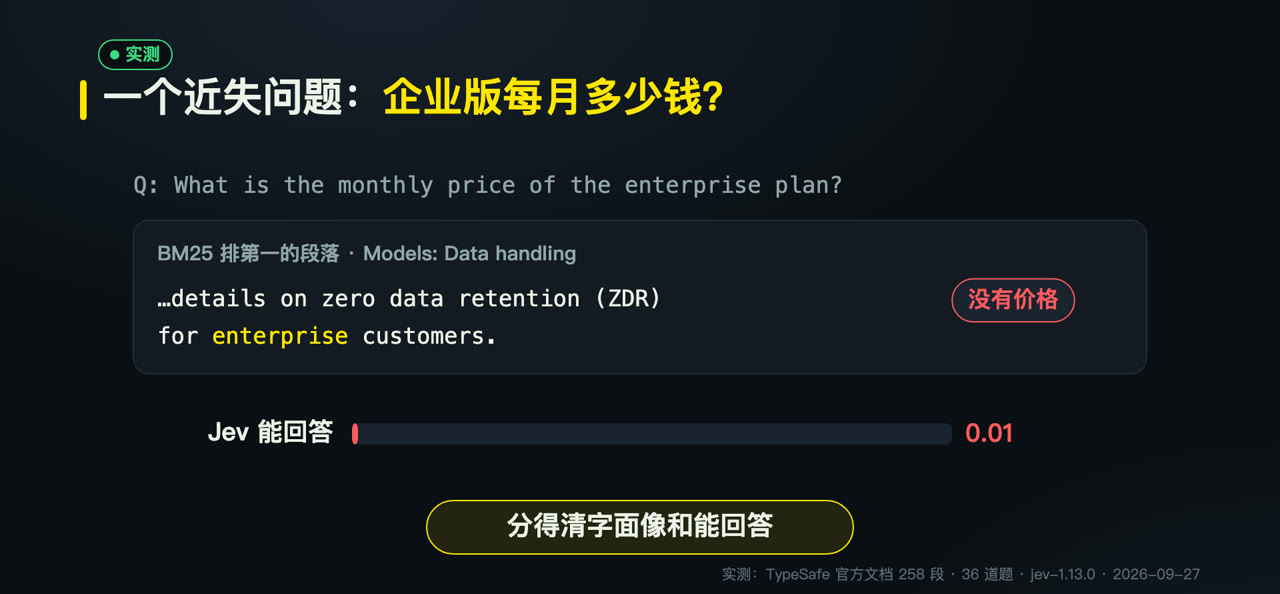
「近失问题」是我借来的说法,指差一点就能答、其实答不了的问题。我写的近失问题包括:Jev 有多少参数,在哪种 GPU 上跑,企业版每个月多少钱,在 MMLU 这个评测上考多少分,创始人是谁。这类问题最危险,因为检索一定能找到很像的段落,大模型最容易被诱导去硬答。
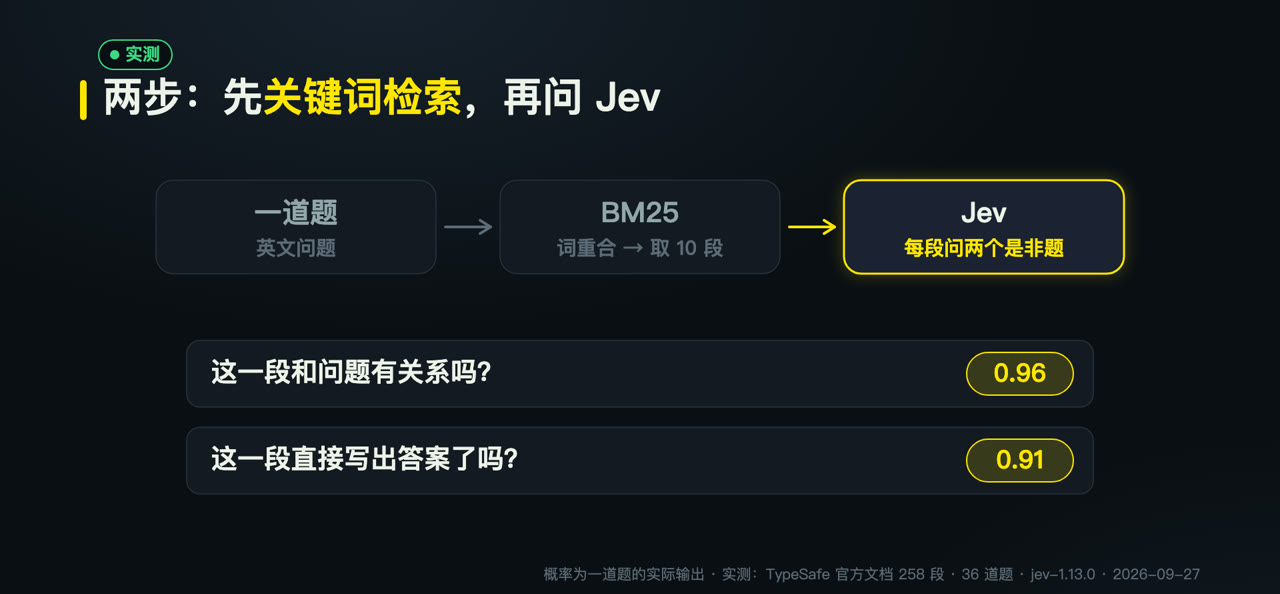
第一步是检索。我用 BM25 对每道题取前 10 段。选 BM25 是因为它简单、透明,而且比较弱,能留出空间看 Jev 帮了多少忙。
第二步是判断。我把问题和每一段放在一起发给 Jev,每道题 10 次请求,4 路并行。每次请求问两个是非题:
这一段和问题有没有关系?这一段有没有直接写出答案?
Jev 对每个是非题返回「是」的概率。我后面的重排、过滤和「能不能回答」,用的都是第二个问题,也就是「写出答案」的概率。第一个问题我也记下了,但没用来做决定。
四、重排:第一名从 7 道到 17 道
先看重排。我关心的是:在 20 道有答案的题里,排第一的那一段是不是答案。按我测的结果,只用 BM25 时有 7 道;让 Jev 按「写出答案」的概率重排后,变成了 17 道。
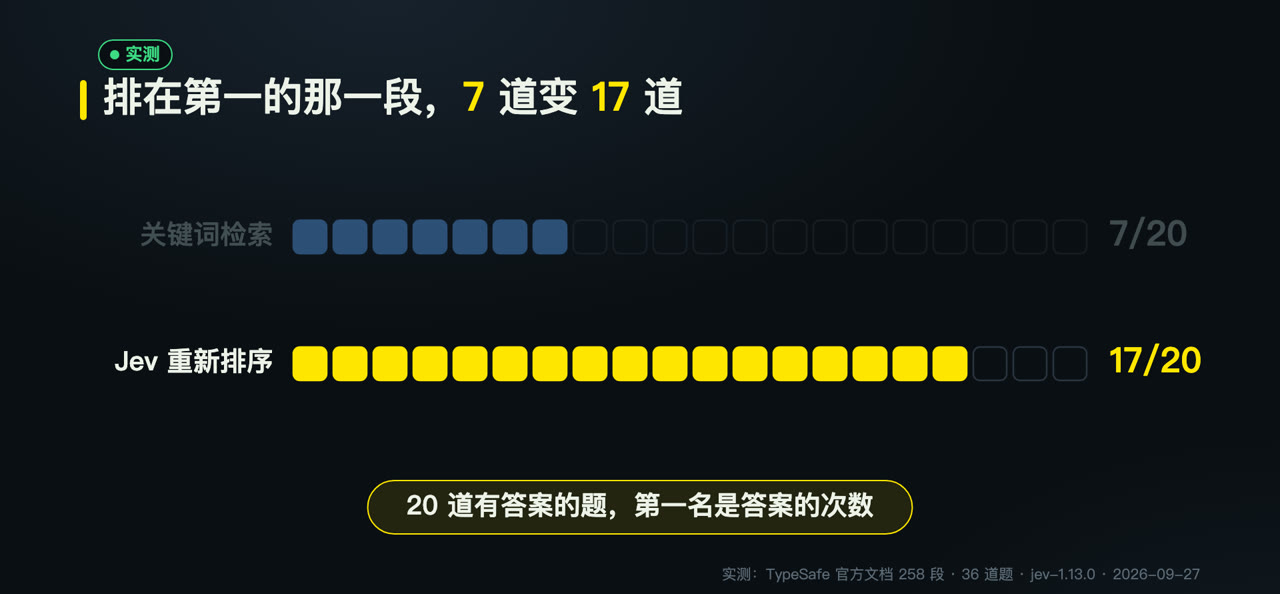
再看细一点。只用 BM25 时,按我测的,答案进了前 3 的有 11 道,进了前 10 的有 17 道。Jev 重排后,第一名是答案的有 17 道,前 3 也是 17 道。
17 这个数就是上限。另外 3 道题,BM25 在前 10 段里根本没找到答案,Jev 手里没有答案可排。换句话说,答案只要进了候选,Jev 每次都把它排到了第一。
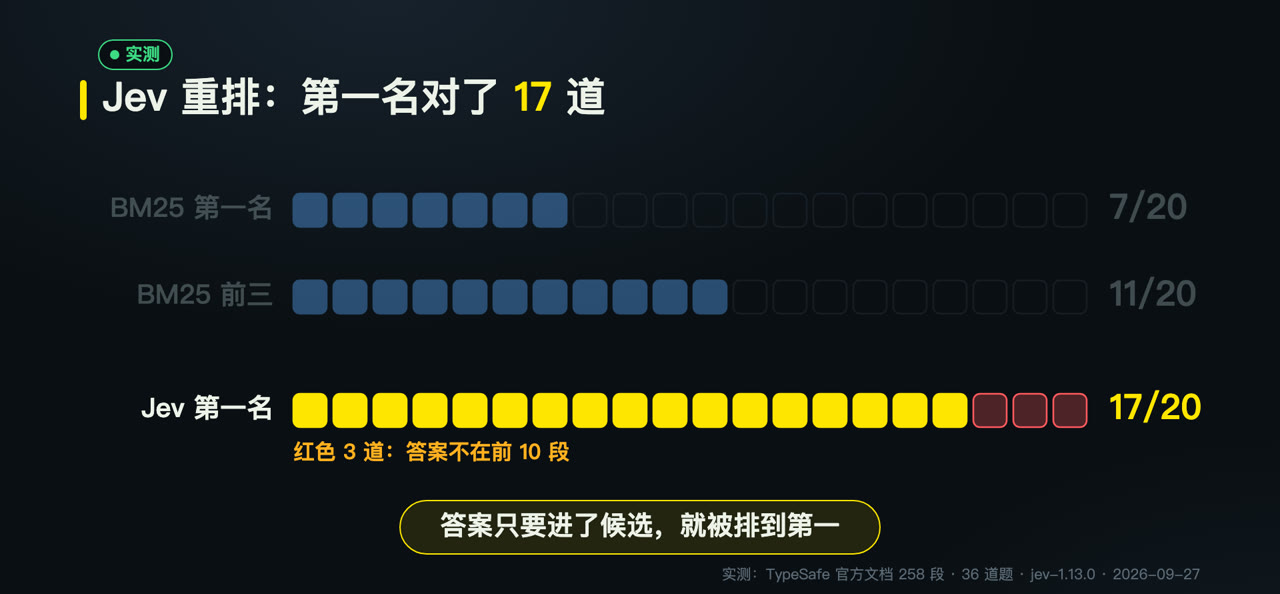
这里要交代一个我改过的地方。第一次跑完之后,我发现有 3 道题,Jev 排第一的段落其实也回答了问题,只是我当初没标。我把这 3 段加进了标准答案。按原来的标准,我测的 Jev 第一名对了 14 道,BM25 仍是 7 道。
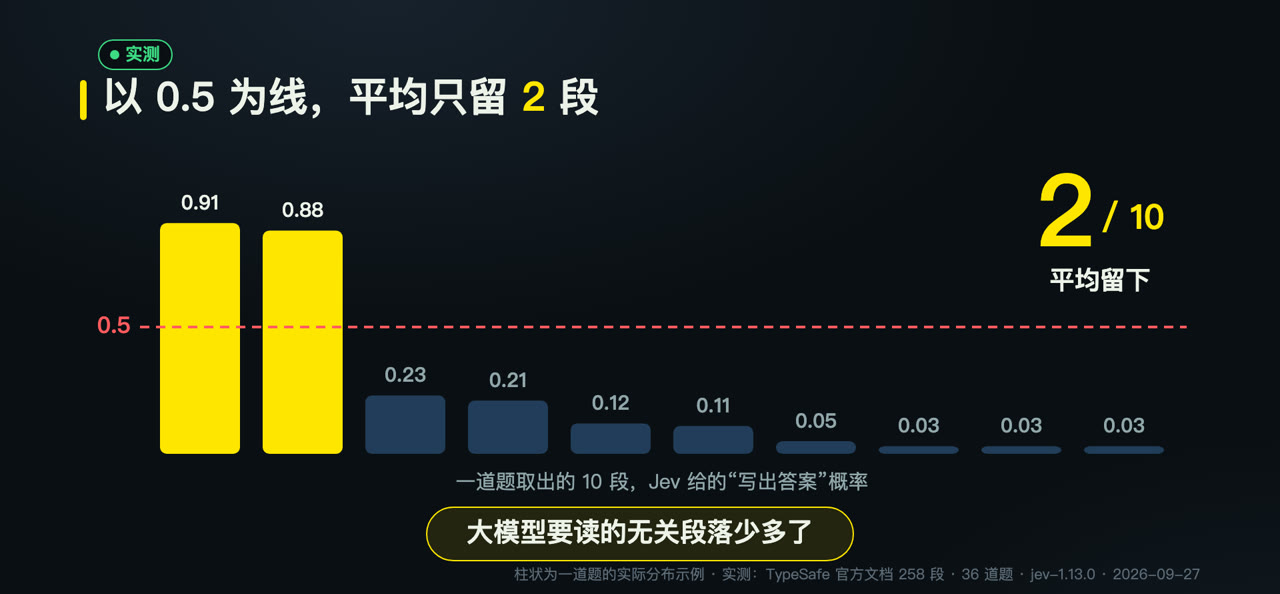
接着看过滤。这里要用到阈值,阈值就是一条分数线,高于这条线才算数。我把线定在 0.5:「写出答案」的概率超过 0.5 的段落留下,其余的丢掉。
按我测的,每道有答案的题,10 段里平均只留下 2 段。其余的段落不用交给大模型。大模型少读无关段落,照着无关内容编答案的机会也就少了。
重排的差距这么大,有一部分要算在 BM25 头上。BM25 是比较弱的检索,换成好的向量检索,重排拉开的差距会变小。那篇博客里各家几乎分不出高下,就是这个原因。所以重排这一节的数字,只能说明 Jev 能把答案挑出来,不能说明你换了 Jev 就会多对这么多。
五、能不能回答
这一节是我最想讲的。重排解决的是「答案排第几」,但还有一个更要紧的问题:候选里到底有没有答案。如果没有,最好的做法是让系统直接说「文档里没写」,而不是交给大模型去编。
我的判断规则很简单。一道题的 10 段里,只要有一段「写出答案」的概率超过 0.5,就算能回答。否则就不调用大模型,直接回复文档里没写。写成伪代码是这样:
probs = [jev_answers(question, p) for p in top10]
if max(probs) > 0.5:
    ask_llm(question, [p for p in top10 if prob(p) > 0.5])
else:
    reply("文档里没有写")
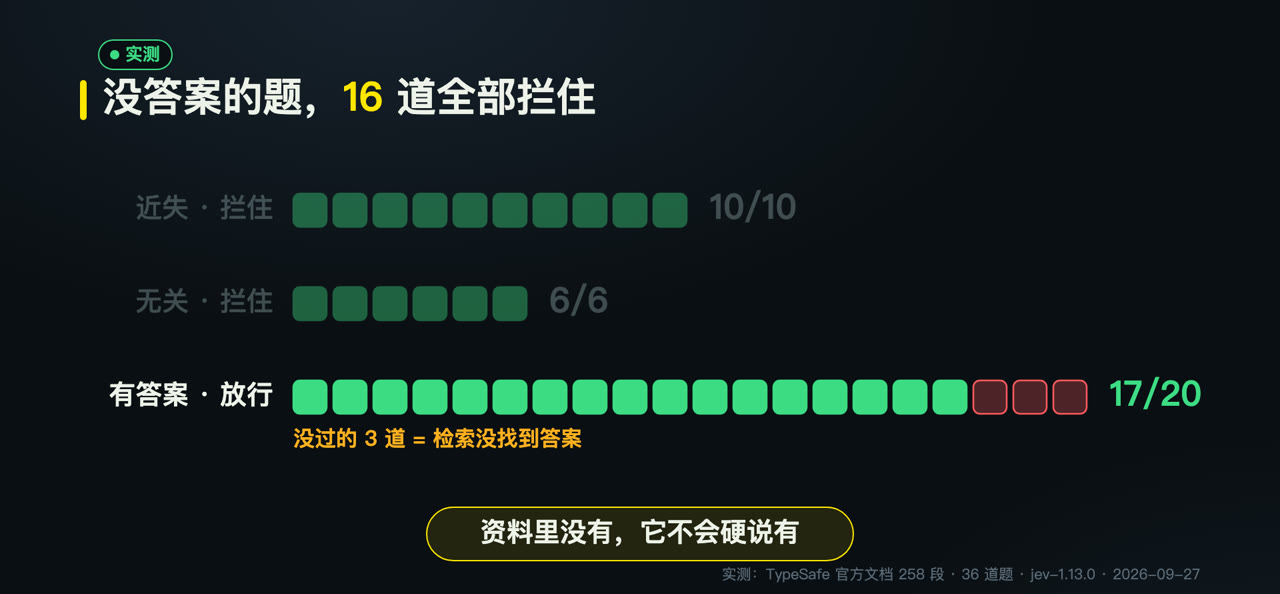
先看结果。按我测的,10 道近失问题,Jev 全部判为答不了,10/10 拦住。6 道完全无关的题,也全部拦住,6/6。20 道有答案的题里,放行了 17 道。
没过的 3 道,正好就是 BM25 没找到答案的那 3 道。这 3 道题的候选里确实没有答案,Jev 没有硬说能答。从系统的角度看,这 3 道题回答「文档里没写」反而是对的,因为交给大模型也只能编。
举一个近失问题的例子。我问的是「What is the monthly price of the enterprise plan?」,也就是企业版每个月多少钱。BM25 排第一的是一段讲企业客户数据保留的文字,结尾提到「zero data retention (ZDR) for enterprise customers」。ZDR 是零数据保留,指服务方不保存客户的数据。
这段话里有 enterprise 这个词,和问题的字面重合度很高,所以 BM25 把它排在第一。但它没有任何价格。Jev 给这段「写出答案」的概率,按我测的是 0.01。如果把这段交给大模型,它很可能会根据上下文编出一个价格。
那只用 BM25 能不能做同样的判断?我也试了。做法是拿每道题 BM25 的最高分卡一条线,高于线算能回答,低于线算答不了。我在这 36 道题上把每条线都试了一遍,挑出了结果最好的那一条。这个做法对 BM25 是有利的,因为真实场景里你没法事先知道哪条线最好。
即使这样,按我测的,BM25 在 36 道题里也只判对了 30 道。Jev 用固定的 0.5,没有挑线,判对了 33 道。36 道题里,Jev 判对 33 道,挑过最好线的 BM25 只判对 30 道。
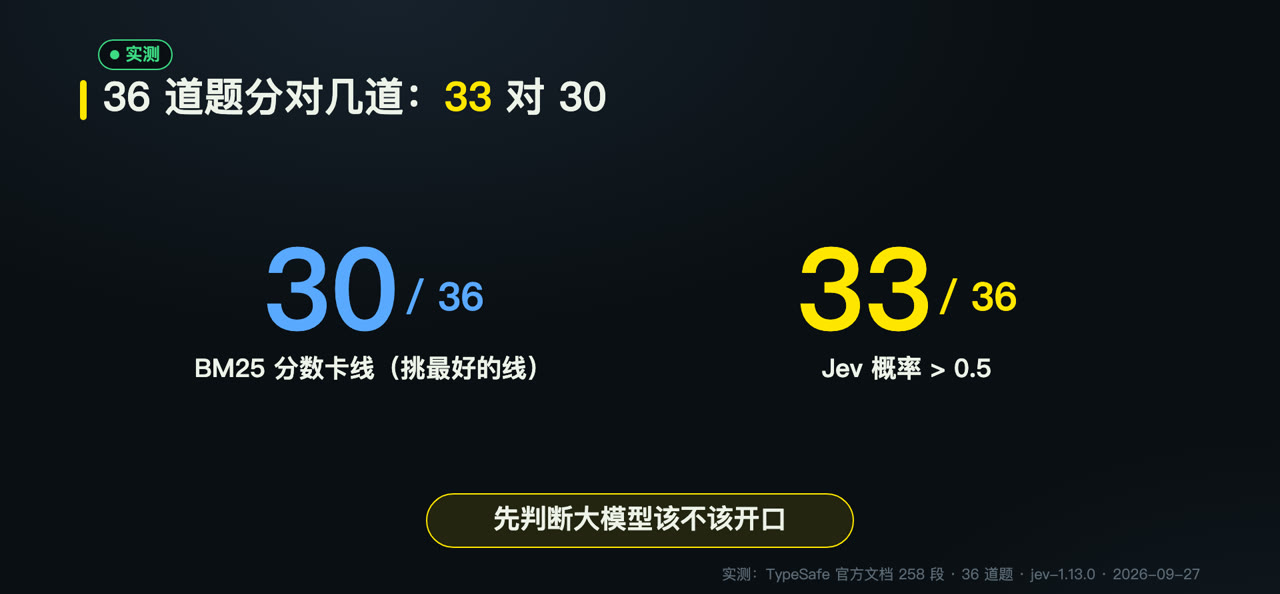
原因不难理解。BM25 的分数衡量的是词重合,近失问题恰恰是词重合很高、答案却不在的那一类。相似度分数回答不了「这一段写没写答案」,而 Jev 被问的正是这个问题。这和那篇博客测的方向一致:在话题对、答案没写的问题上,那篇博客测的 Jev 是 99.2%,Cohere 用分数卡线是 65%。
把第四、五节的结果汇总在一起:
| 指标(我测的) | BM25 | Jev |
|---|---|---|
| 20 道有答案的题,第一名是答案 | 7 道 | 17 道 |
| 20 道有答案的题,答案进前 3 | 11 道 | 17 道 |
| 36 道题,能不能回答判对 | 30 道(挑了最好的线) | 33 道 |
六、成本,以及它该放在哪
先说成本。模型按 token 计费,token 是模型读文字时切出来的小块,一个词可能是一个或几个 token。官方价格是每百万输入 token 0.042 美元,输出不收费。
按我测的,整个实验一共 360 次请求,每次平均 554 个输入 token。总花费是 0.0084 美元,一道题约 0.00023 美元,换算下来一千道题约 0.23 美元。单次请求的中位延迟是 223 毫秒,90% 的请求在 303 毫秒以内,条件是 4 路并行。
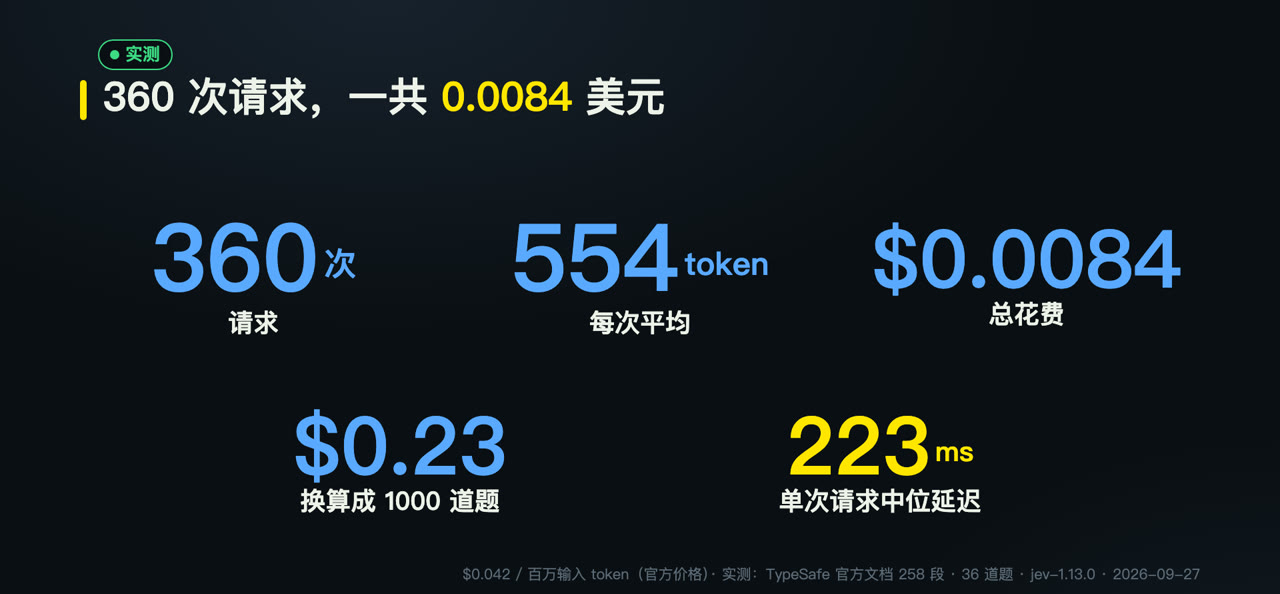
那篇博客测的「每千次 0.25 美元」是按请求算的,我的「一千道题 0.23 美元」是按题算的,每道题 10 次请求。两个数的单位不同,不能直接比。但不管按哪种算,这一层判断的成本都很低。
再说位置。TypeSafe 官方有几篇 cookbook 讲 Jev 在 RAG 里怎么用。cookbook 就是官方给的示例配方,一篇讲一种用法,附带能跑的代码。
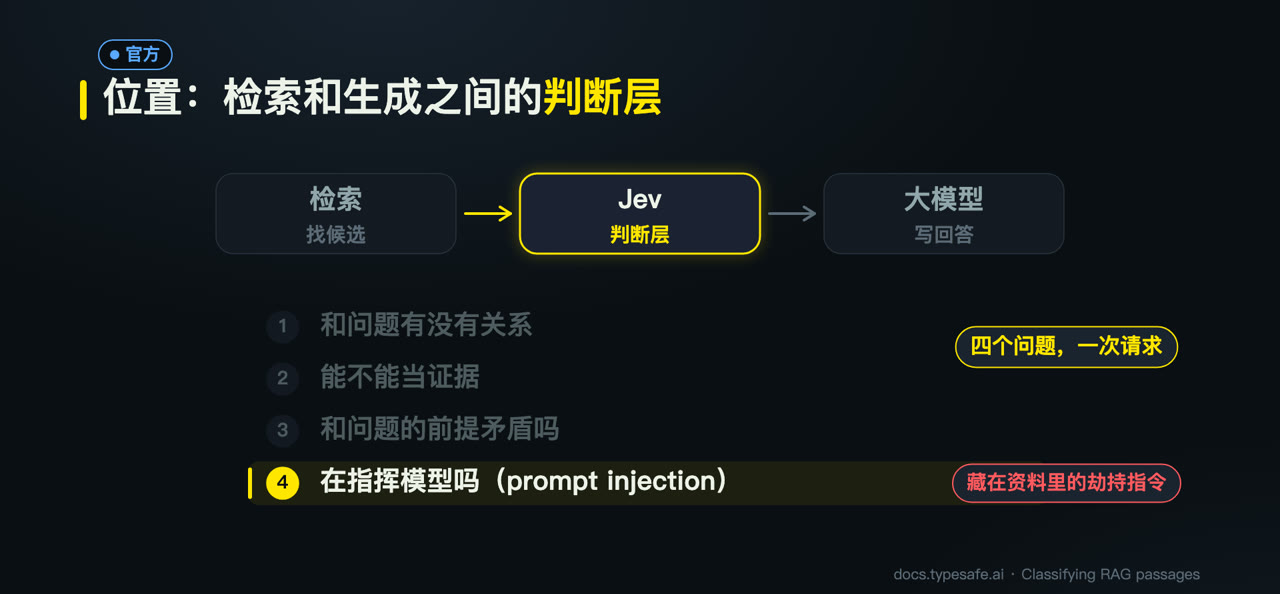
第一篇是「Classifying RAG passages」。它把 Jev 放在检索之后、生成之前,对每一段问四个是非题:
- 这一段和问题有没有关系。
- 这一段能不能当证据。
- 这一段和问题的前提是否矛盾。
- 这一段是不是在指挥模型。
最后一个问题针对的是 prompt injection。prompt injection 指有人把指令藏在资料里,想劫持读到这段资料的大模型。官方的做法是四个问题一次请求,阈值写在代码里,由代码决定这一段是当证据、当冲突信息,还是丢掉。
第二篇是「Re-ranking」。官方的做法是先用 BM25 取 30 段短名单,再让 Jev 给每一对(问题, 候选)打分重排。官方在 40 个法律问题上演示,top-1 从 5% 升到 18%,top-10 从 38% 升到 62%。官方自己也说样本小,这是配方演示,不是评测。
第三篇是「Double-checking citations」,放在生成之后。大模型写完回答,每句话都附了出处。Jev 拿一段引用对一句话,判断这段出处是否支持这个主张。
规模上,结论和 Viv 说的差不多。资料少的时候,可以不用向量库,直接让 Jev 给每一段打分。资料多的时候,先用 BM25 或向量检索取前几十段,再交给 Jev 重排和过滤。
我的看法是,Jev 适合当 RAG 的裁判,也就是一个判断层,不适合替换整条 RAG。它最有价值的地方,是在大模型开口之前,判断该不该开口。
七、它做不到的
说完能做的,也要说清楚做不到的。我整理成五条:
- Jev 不写答案,最后的回答还要交给大模型。
- 检索漏掉的答案,Jev 救不回来。
- 整个资料库不能一次塞给 Jev,一次请求有 token 上限。
- Jev 英文最准,中文要先用自己的数据测。
- 我的实验样本小,结论不能直接套到你的语料上。
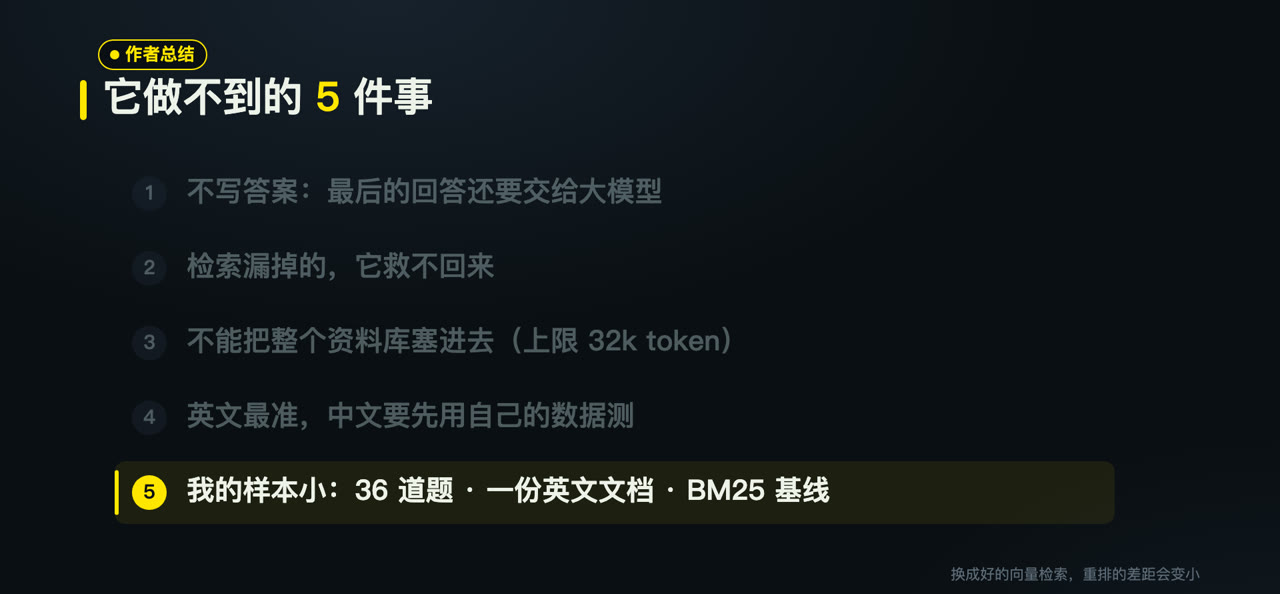
第一条是官方写明的:Jev 不生成文字。它能告诉你哪一段有答案、该不该回答,但写回答的还是大模型。
第二条,我那 3 道题就是例子。BM25 没把答案放进前 10 段,Jev 再准也只能说「答不了」。它能保证不硬答,但不能把答案变出来。检索的召回还是要靠检索自己。
第三条有两层原因。官方说一次请求的状态加上最长的一个问题,上限是 32k token,整个请求 64k token,而且只收文本。另外,官方的 jaggedness 文档写明:状态里无关的内容越多,准确率越低,应该先在代码里检索和过滤。所以「把整个资料库丢给 Jev 自己挑」这条路是走不通的。
第四条也来自官方:英文最准,中文等其他语言能用,但没有英文那么好。我的实验只用了英文文档和英文问题。如果你的资料是中文,请先拿自己的数据测一轮,再决定要不要上。
第五条是我自己的局限。36 道题和标准答案都是我写的,只有一份英文文档,检索用的是比较弱的 BM25。第一次跑完后,我还补过 3 道题的标准答案。热帖里「解决了精度」这类说法,也不要直接当成你自己语料上的结果。
八、写在最后
回到开头的问题:Jev 该插在 RAG 的哪一步。我的答案是检索之后、生成之前,当一个裁判。它不负责找资料,也不负责写回答,负责判断每一段有没有写出答案,以及这道题到底能不能回答。
在我的小实验里,它在两件事上都有用。一是把答案排到第一,前提是答案已经进了候选。二是在资料里没有答案的时候拦住大模型,近失和无关的题全部拦住了。我认为第二件事比第一件更值钱,因为硬答的错最难被发现。
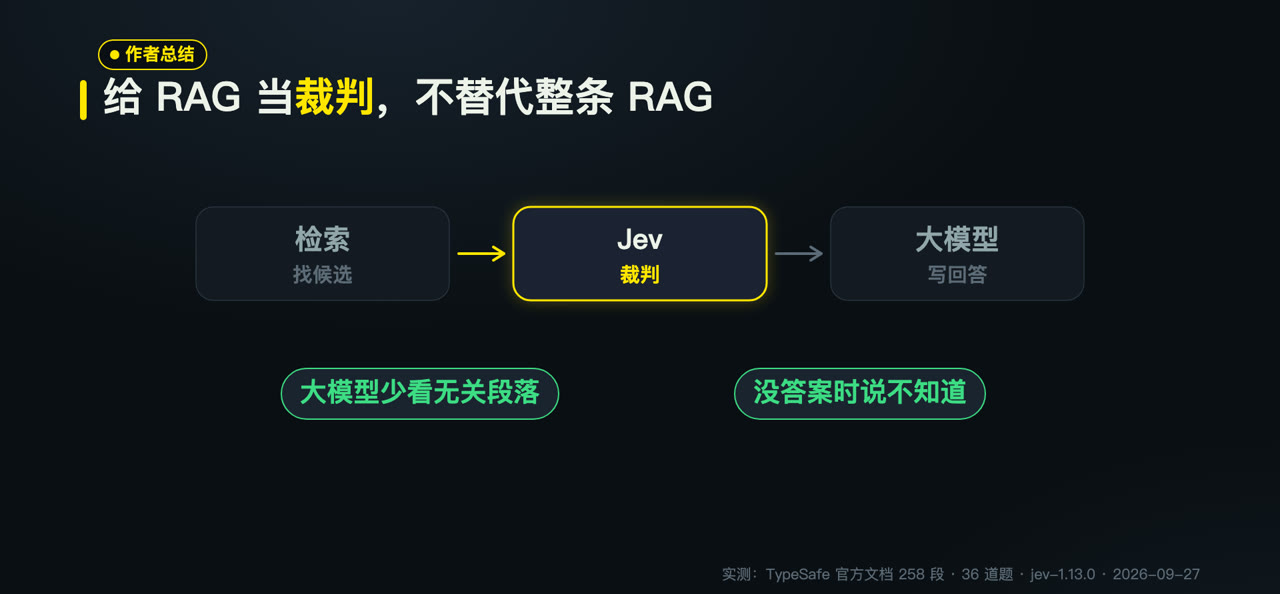
如果你想试,我建议从「能不能回答」这一步开始。不用改现有的检索,只在检索和大模型之间加一次判断:候选里没有一段写出答案,就直接回复「文档里没写」。先拿自己的数据跑一轮,看它拦住了多少本该拦住的题,又误拦了多少。这一步跑通了,再考虑重排和过滤。
最后想问问你:你的 RAG 最常见的错,是找错了资料,还是资料里没有却硬答?欢迎在留言里说说你的情况,也欢迎拿我的代码在自己的语料上跑一遍,把结果告诉我。
参考:TypeSafe 官方文档:docs.typesafe.ai(Models、Classifying RAG passages、Re-ranking、Double-checking citations、Jev 1.13 jaggedness)
我的实验代码与结果:github.com/DDnim/jev-rag-bench