VIDEO · 2026
Jev 的 10 种用法:我把它接进自己的 3 件事做了实测
一支 10 分钟的讲解视频,附完整图文。任务路由 20 张选对 17 张,看板分类正确率 87%,SQL 能否上线 14 条全对;再整理出 10 种用法、它和大模型怎么分工,以及它不行的地方。
中文旁白 · 720p · 字幕轨道 · MP4
文章:Jev 的 10 种用法,和我的 3 个实测
最近我在试一个有点特别的模型,叫 Jev。它是 TypeSafe 这家公司在 2026 年 9 月发布的。Jev 不写文章,也不陪你聊天。它只回答带选项的问题,然后给出每个选项的概率。
我关心它,是因为自己的工作流里有很多这样的问题。我平时用 Obsidian 里的一个看板,管理交给 AI 做的任务。每张卡都要决定几件事:交给哪一档大模型,推理开多强,属于哪个项目。这些决定都只是一个判断,不需要写一段话。所以我想知道,这类判断能不能交给 Jev,它又适合放在系统的哪个位置。
这篇文章先讲清楚 Jev 是什么,再讲我自己测的三件事。接着是我整理的 10 种用法,以及它和大模型怎么分工。最后说说它不行的地方,这部分和前面一样重要。
一、Jev 是什么
TypeSafe 官方把 Jev 叫做系统 1 模型(System One Model)。这个名字来自《思考,快与慢》这本书。书里把人的思考分成两套,系统 1 是快速的直觉,系统 2 是慢慢推理。Jev 想做的是前一种。
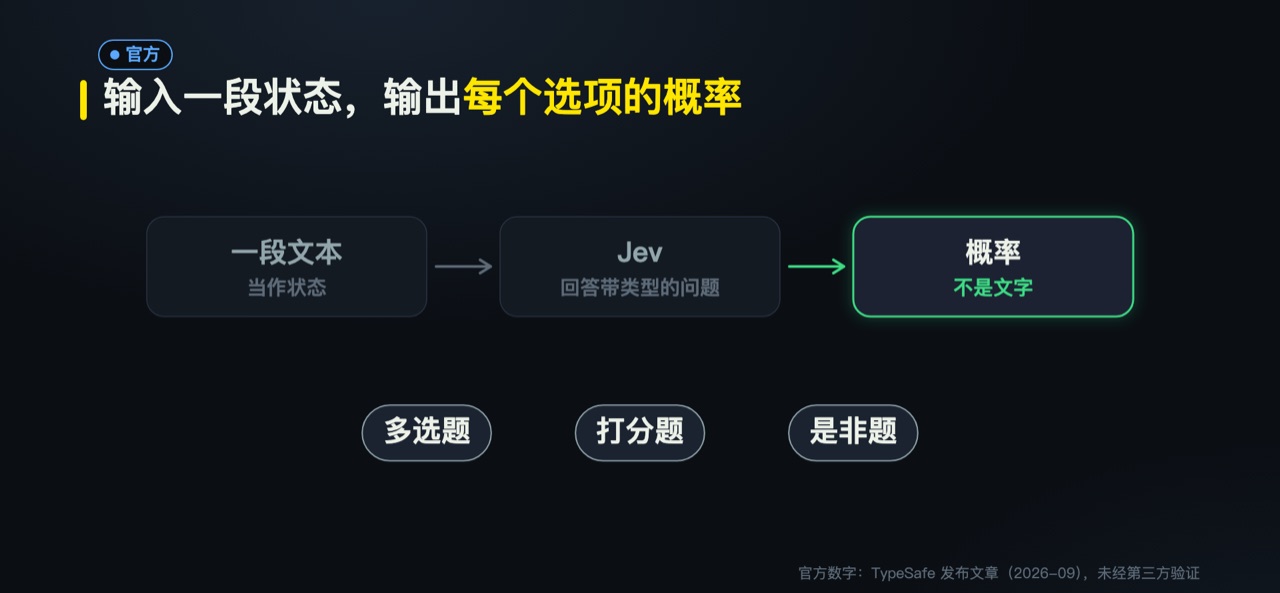
它的输入分两部分。第一部分是一段状态,可以是一段文本、一张卡片,也可以是一条帖子。第二部分是几个带类型的问题。问题只有三种:
- 多选题:从几个选项里挑一个,比如这张卡属于哪个项目。
- 打分题:给出一个分数,比如这条 SQL 的开销有多大。
- 是非题:回答是或不是,比如这条语句能不能直接上线。
它的输出不是文字,而是每个选项的概率,打分题则给一个分数。平常的大模型(也叫 LLM)是一个字一个字往外生成的。Jev 只做一次前向传播,也就是把输入从头到尾算一遍,就得出结果。因为不生成文字,它不会输出选项以外的东西。对写代码的人来说,返回值的类型是确定的,可以直接拿去做分支。
官方还说,它的概率是校准过的。校准的意思是,它说出来的把握,要和它实际的准确率一致。就像天气预报说七成会下雨的那些日子里,大约七成真的下了雨。这是 TypeSafe 的训练目标,我没有验证过,只能先记着。
速度和价格也都是官方公布的。官方的数字是一次判断 70 到 500 毫秒。计费按 token 算,token 是模型计算文字量的单位,大致是一个词或一个字的片段。输入每一百万个 token 收 0.042 美元,输出不收费,因为没有生成文字这一步。官方举的例子是,给 5000 万条商品评论打分大约 20 美元。
我自己通过 API 调用时也量了延迟,这个数字包含网络往返。我测的中位延迟,SQL 实验是 524 毫秒,任务路由实验是 545 毫秒。比官方给的区间上限稍慢一些,但也就是半秒多一点。
TypeSafe 自己把它叫做聪明的 if 语句(smart if-statements),用来分类、路由、打分、提取和分支。我更愿意换一个说法:
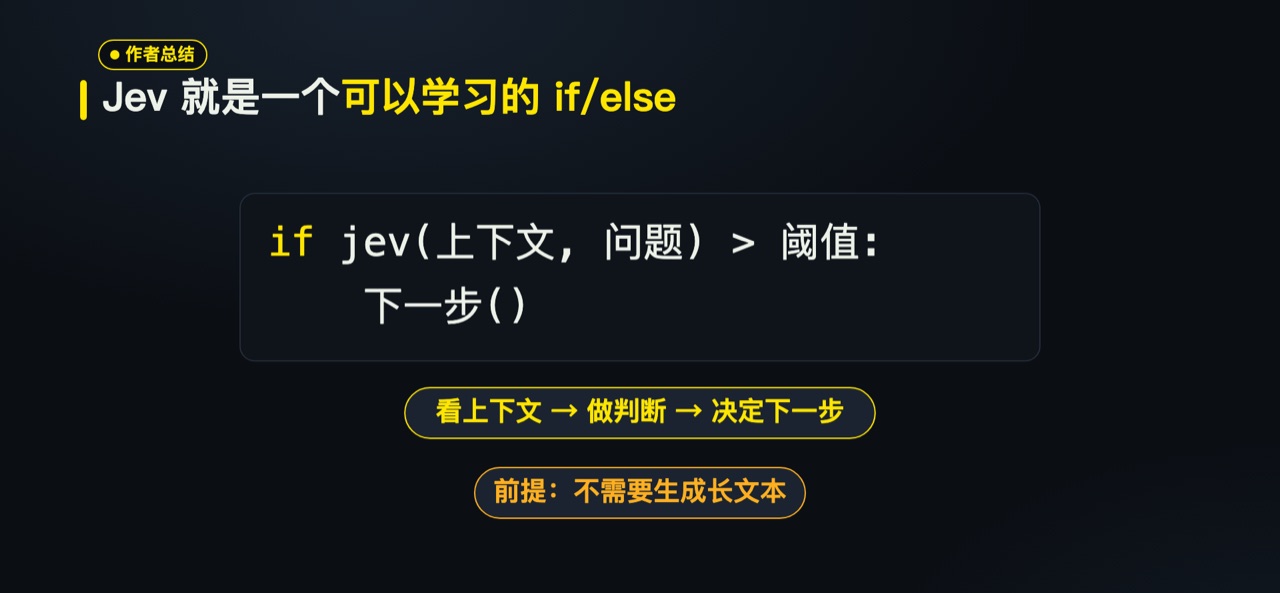
Jev 就是一个可以学习的 if/else。
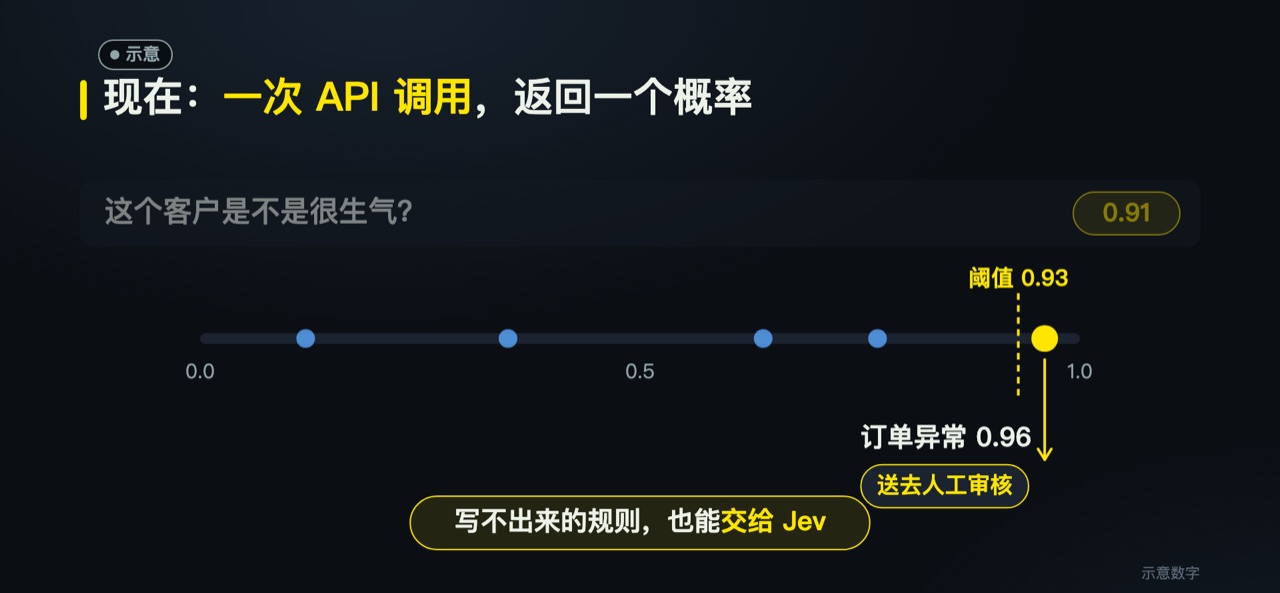
任何拿到上下文、做一个判断、再决定下一步的地方,只要不需要生成长文本,都适合它。举个例子,如果 Jev 判断「这个订单看起来异常」的概率大于 0.93,就送去人工审核。这里的 0.93 叫阈值,也就是事先定好的一条分界线,数字本身只是示意。写在代码里大概是这样:
if jev(订单, "这个订单看起来异常吗") > 0.93:
    送去人工审核()
对调用方来说,它和一个普通函数没有区别。传进去一段上下文和一个问题,拿回来一个数,剩下的交给代码。唯一的前提是,你要的答案能写成选项或分数,而不是一段话。
二、我先测了三件事
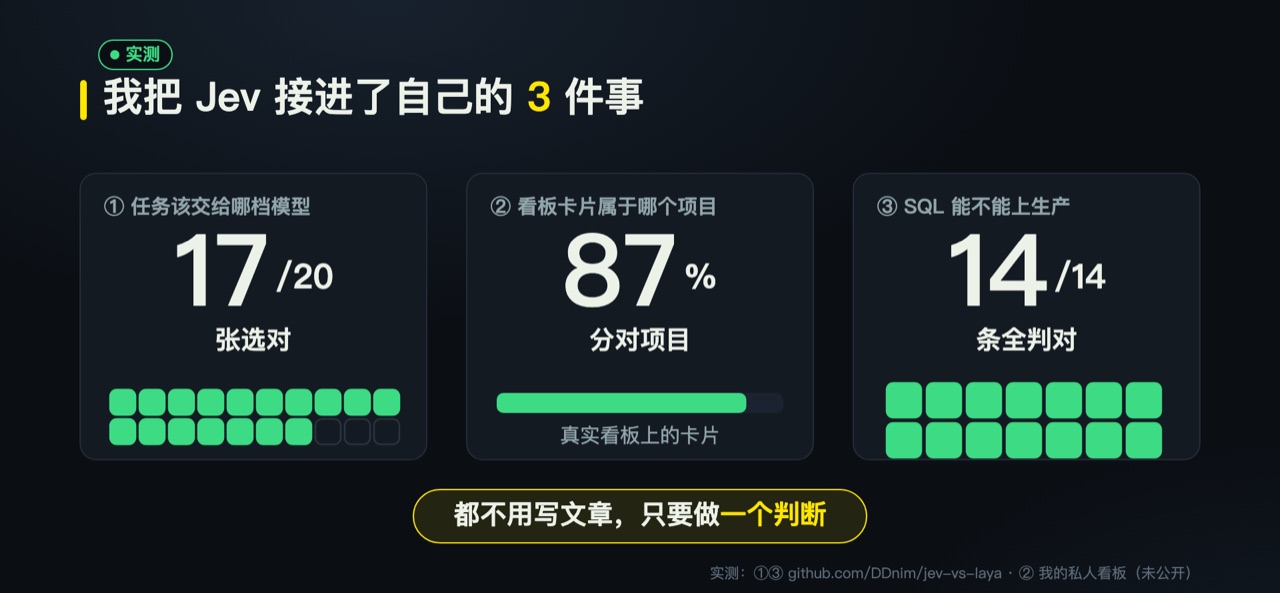
官方的数字再漂亮,也要放进自己的场景里看。2026 年 9 月 21 日到 23 日,我把 Jev 接进了自己手上的三件事:任务路由、看板分类、SQL 审查。这三件事有一个共同点,都不用写文章,只要做一个判断。任务路由和 SQL 审查的代码和原始结果公开在 github.com/DDnim/jev-vs-laya。看板分类用的是我自己的私人卡片,所以没有公开。
第一件是任务路由。我写了 20 张合成的任务卡,中文、日文、英文混在一起,模仿我的个人看板。每张卡我事先标好两个答案。一个是该交给哪一档大模型,按价格从便宜到最强分四档:flash、sonnet、opus、fable。另一个是推理该开多强,分 0 到 3 四级。
给 Jev 的状态只有卡片文字。四档模型各自适合什么任务,我写在问题的说明里。这样 Jev 要做的事,就和我每天手动分配卡片时想的一样。
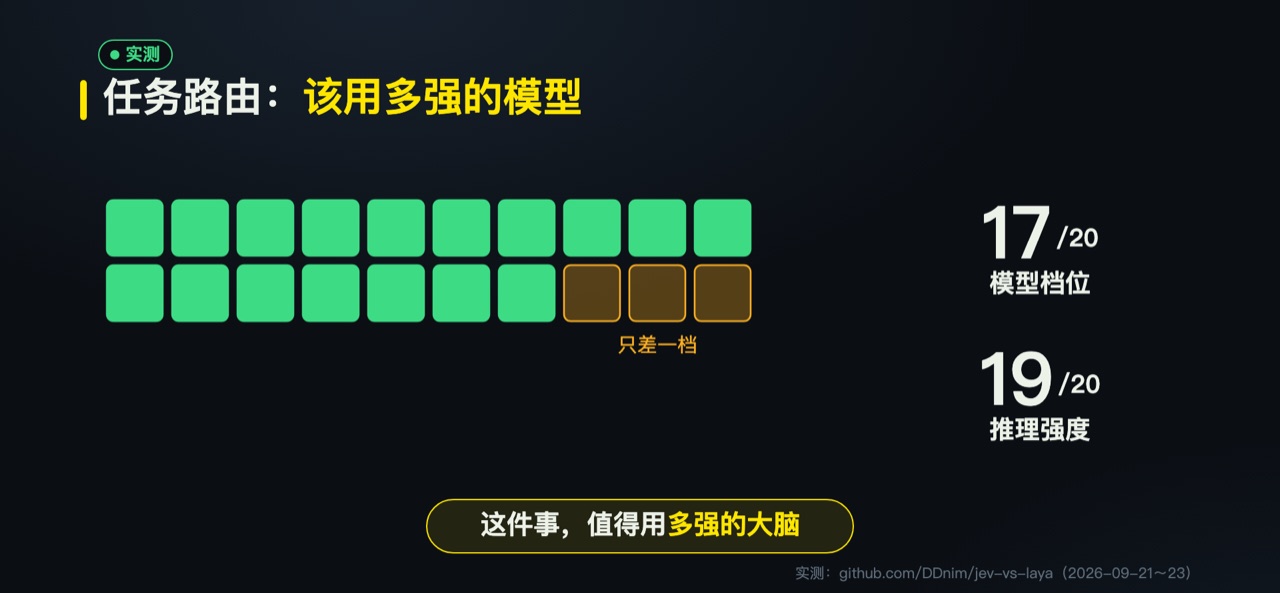
结果是,选模型档位,20 张里对了 17 张。选推理强度,20 张对了 19 张;如果允许差一级,20 张全对。选错档位的 3 张都只差一档,而且都是边界上的卡。比如一张调研卡,我标的是 sonnet,它选了 opus。一张写好规格的多文件功能,我标的是 opus,它选了 sonnet。
这说明什么?判断「这件事值得用多强的大脑」,本身就是一个典型的小判断。Agent 就是让大模型自己一步一步完成任务的程序,它每走一步都要做类似的决定。后面讲用法时,我会再回到这一点。
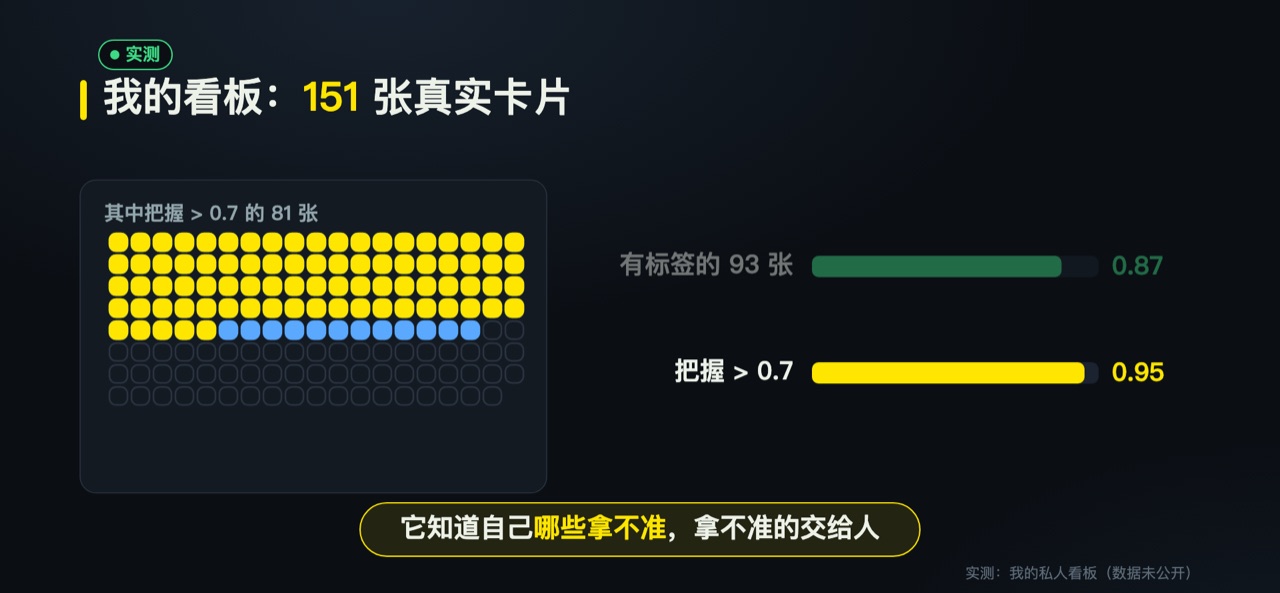
第二件是真实看板的项目分类。我的看板里有 151 张真实卡片,其中 93 张带着项目标签,正好拿来对答案。选项一共 7 个:6 个项目,加一个「其他」。给 Jev 的状态是卡片的标题和正文。
结果是 93 张里分对了 81 张,正确率 87%。这个数字本身不算特别高,更有意思的是它的把握。我只看它自己把握在 0.7 以上的卡片,一共 81 张,其中对了 77 张,正确率 95%。
它知道自己哪些拿不准。
这说明概率不只是一个装饰。把握高的可以直接用,把握低的交给人,整个流程就自然分成了两条路。人只需要看剩下那一小部分卡片。
第三件是 SQL 审查,这是我设计得最细的一组。我准备了 14 条 PostgreSQL 语句,每条都写明了想做什么。每条还附上同一份表结构,包括 5 张表、各表的行数和索引。
14 条里有 6 条是对的,另外 8 条各藏了一个 bug。有的是 JOIN 以后金额被重复累加,有的是用 = NULL 做比较,永远查不到。有一条 DELETE 因为 OR 写错,会把两年以前的所有订单一起删掉。有一条 UPDATE 没写 WHERE,会改掉全部 8000 万行。还有一条本该用 NOT EXISTS,却写成了 cross join。
剩下三条也都是真实工作里会踩的坑。一条在 8000 万行的表上 CREATE INDEX 没加 CONCURRENTLY,会锁表。一条是 BETWEEN 让日期多算了一天。还有一条残留了 OR 1=1 注入。
每条语句我问 Jev 四个问题。第一个是能不能直接上生产,意思是只读、不经人工确认也安全,这是是非题。第二个是逻辑对不对,也是是非题。第三个是开销大不大,打分题,分 0 到 2。第四个是属于哪一类,多选题,选项有报表、破坏性操作、改表结构。
| 问题 | 题型 | 结果 |
|---|---|---|
| 能不能直接上生产 | 是非题 | 14/14 |
| 逻辑对不对 | 是非题 | 13/14 |
| 开销大不大 | 打分题(0 到 2) | 9/14 |
| 属于哪一类 | 多选题 | 14/14 |
能不能上生产这一题,它的概率分得很开。DELETE、UPDATE 和改表结构的语句,它只给了 0.01 到 0.03。普通的查询它给了 0.73 到 0.90,带注入的那条给了 0.10。
逻辑这一题,唯一漏掉的是 BETWEEN 那条。它认为那条是对的,给出的正确概率是 0.83。日期边界多算一天,这种 bug 本来就藏得深,但它确实没看出来。
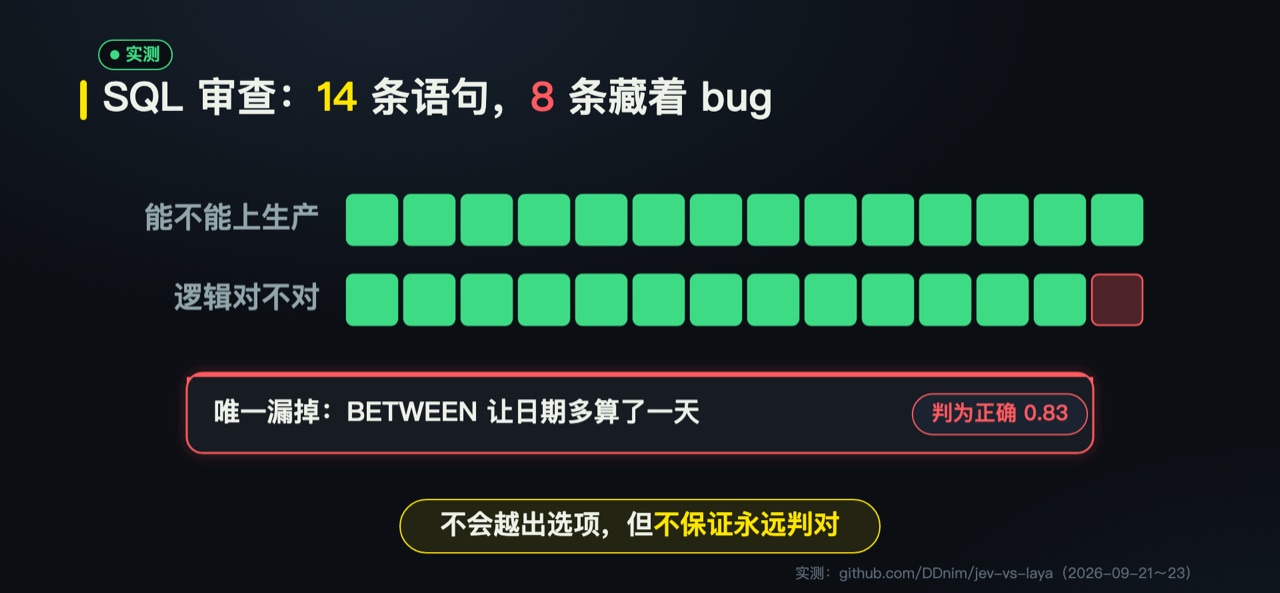
这组结果让我对「类型安全」有了更准的理解。类型安全只保证它不会输出选项以外的东西,不保证判断永远对。 开销这一题只对了 9 条,也说明不是每个问题它都一样准。所以用之前,最好针对自己的问题单独量一次。
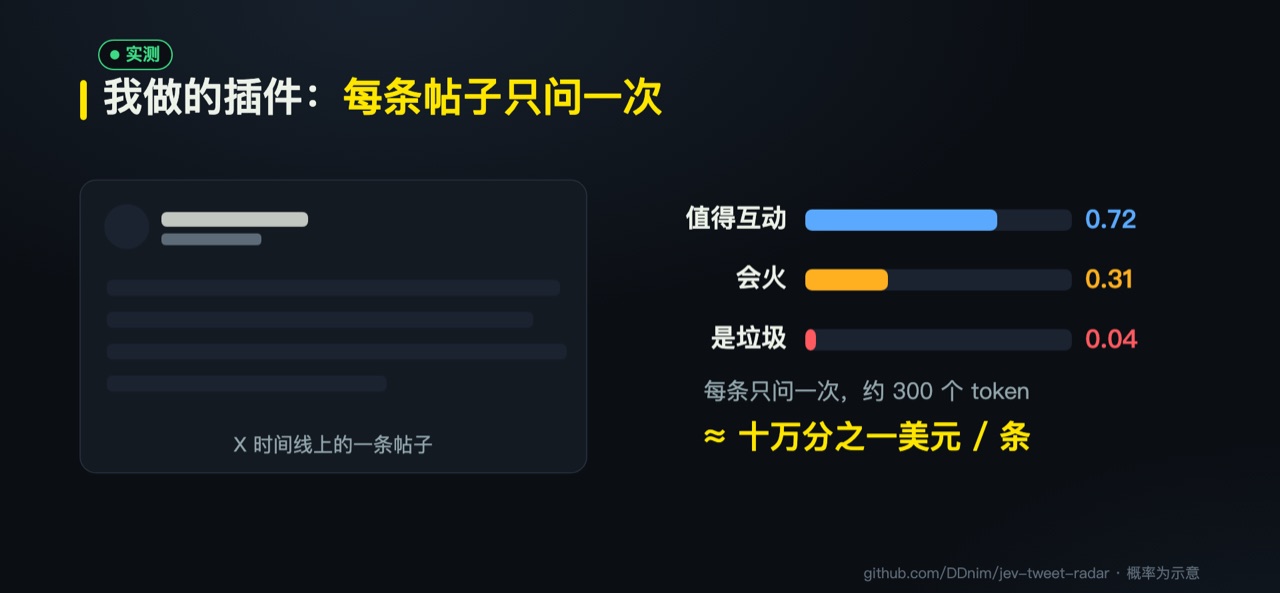
除了这三组实验,我还做了一个小工具,不算正式实验。这是一个 Chrome 插件,开源在 github.com/DDnim/jev-tweet-radar。刷 X 的时候,每条帖子只问 Jev 一次。一次请求就能同时拿到值不值得互动、会不会火、是不是垃圾等几个概率。
我自己试的情况是,一次判断大约输入 300 个 token,折合大约十万分之一美元,输出不收费。这样的成本,让「每条都问一遍」变得不用犹豫。需要提醒的是,Jev 不给理由,而且帖子正文会发送到 TypeSafe 的 API。
三、10 种用法
下面是我整理的 10 种用法,分成四组:后台与数据、Agent、过滤与裁判、实时判断。其中第 1 种是我认为商业价值可能最大的,第 2 种是最容易被低估的。
第 1 种用法是软件后台的模糊规则,我认为它的商业价值可能最大。过去的规则写死在代码里,比如金额超过一万就触发审核。但很多判断写不成一行代码。这个客户是不是很生气,这是不是退款请求,这个 bug 严不严重。这封邮件是不是销售机会,这次投诉要不要马上升级,也都一样。
有了 Jev,每个判断变成一次 API 调用,返回一个概率,代码再用阈值分支。比如把阈值定在 0.93,越过这条线就送去人工审核。以前这些判断只能靠人看,或者干脆不做。现在它们可以像普通规则一样,写进后台的流程里。
第 2 种用法是海量离线数据加工,我觉得它最容易被低估。比如十亿条评论、日志、客服记录,你只想知道几件事:相不相关,什么主题,什么情绪,有没有购买意图,有没有风险。以前要么规则覆盖不全,要么调大模型又慢又贵。
这类事可以看成语义级别的 MapReduce。MapReduce 原本是一种批处理的思路,把同一个操作并行跑在海量数据上,再汇总结果。这里的「操作」换成了一个语义判断。官方说 5000 万条评论打分约 20 美元,说的就是这一类。我的看板分类也属于这一类,只是规模小得多。
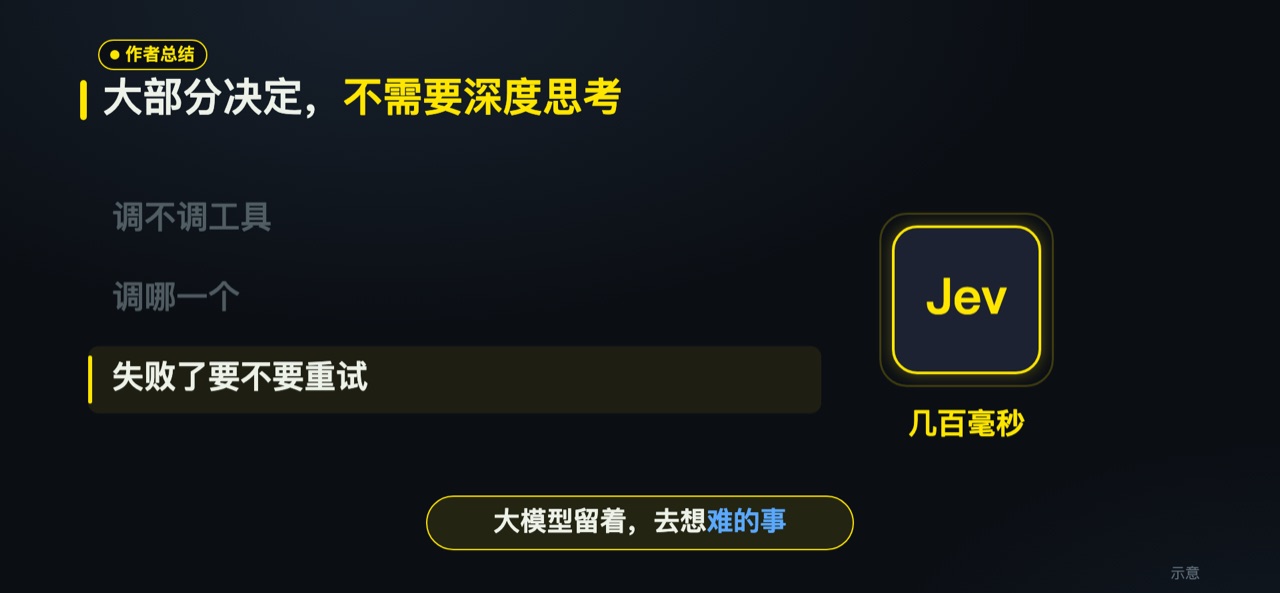
第 3 种用法是 Agent 的小脑。现在的 Agent 每走一步,都要调一次大模型来决定下一步。但大部分决定不需要深度思考:要不要调工具,调哪一个,要不要重试。任务完成了没有,该不该问用户,要不要交给人工,也是同样的小判断。这些判断 Jev 几百毫秒就能给出,大模型可以留着去想难的事。前面的任务路由实验,测的正是这一类判断。
第 4 种用法是 Computer Use,也就是让 AI 看着屏幕操作电脑。屏幕状态进来,Jev 判断下一步是点击、滚动、输入、等待、返回、问用户还是结束。大模型定计划,Jev 负责几百个小操作里的局部判断。这样就不用每点一下鼠标,都重新推理一次。TypeSafe 官方的演示里,Jev 实时玩射击游戏 Doom,每秒大约做 10 次决定。
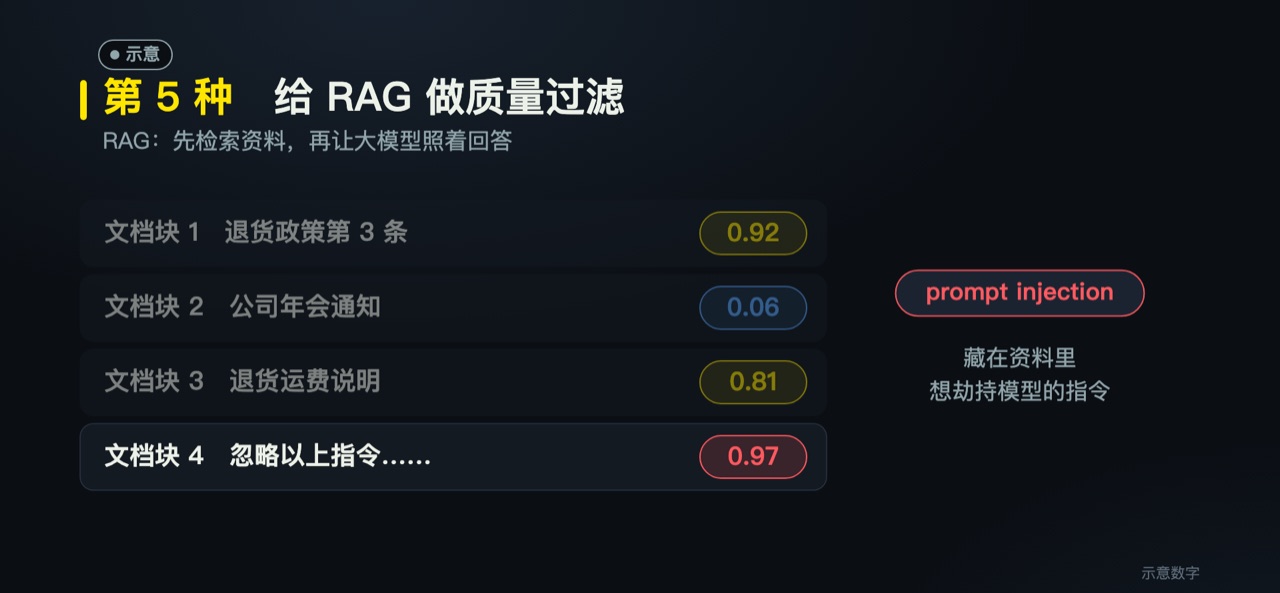
第 5 种用法是给 RAG 和记忆做过滤。RAG 就是先检索资料,再让大模型根据资料回答。检索回来的文档块里,很多是噪声。Jev 可以给每一块打分:和问题相不相关,有没有答案的依据,和别的资料冲不冲突。它还能判断里面是不是藏着 prompt injection,也就是藏在资料里、想劫持模型的指令。
记忆也是同样的道理。这条信息值不值得长期保存,这个问题要不要去读记忆,旧的记忆该不该淘汰。这些都不需要回答问题,只需要一个分数。
第 6 种用法是给大模型的输出当裁判。回答了问题没有,跑题没有,有没有引用证据,格式对不对,前后有没有矛盾。值不值得重新生成,两个版本哪个更好,也可以一起问。Jev 一次请求就能返回多个概率,不用再让大模型写一大段评语。前面的 SQL 审查就是这一类,一条语句同时问了四个问题。
最后四种用法有一个共同点:判断要又快又便宜,而且频率很高。
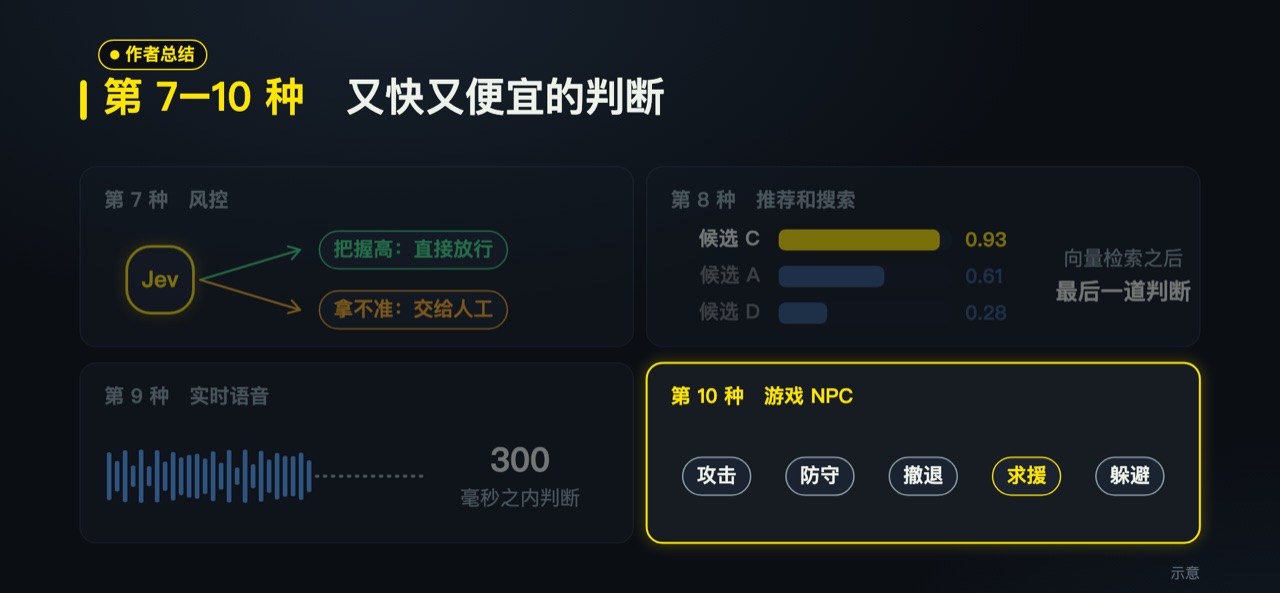
第 7 种用法是风控。欺诈、账号异常、垃圾信息、机器人、支付风险,都只需要回答是或不是。可以把 Jev 当成第一层便宜的过滤。把握很高的正常请求直接放行,风险高的交给规则或更强的模型,拿不准的交给人工。这样人要看的量就少很多,思路和看板实验里「把握高的直接用」是一样的。
第 8 种用法是推荐和搜索。Jev 不取代向量检索和排序模型,而是补在最后一步,做语义判断。比如把几十个候选重新排序,或者判断用户现在更想看哪一类。
第 9 种用法是实时语音对话。系统要判断用户说完了没有,是停顿还是结束,该不该打断,是不是背景噪音。这种判断要在 100 到 300 毫秒之内给出,完整的大模型太慢。这是我对场景要求的理解,Jev 在这里的表现我没有测过。
第 10 种用法是游戏 NPC,也就是游戏里由程序控制的角色。NPC 要根据敌人状态、地形和玩家行为,选择攻击、防守、撤退、求援还是躲避。大模型管剧情和台词,Jev 管高频的行为选择。
四、它和大模型怎么分工
这一节是我的看法,不是实测。我的核心想法可以用一句话说:
大模型负责想,Jev 负责盯着大模型、控制大模型。
大模型回答的是「应该怎么做」。Jev 不断回答另外几件事:现在该不该做,做到哪了,成功了吗,下一步是什么,还需要大模型吗。把这两类问题分开,很多系统设计就清楚了。
第一种循环是大模型先生成,Jev 再判断。Jev 判断的是够不够好、有没有回答问题、要不要重来。它也可以判断有没有明显的幻觉,也就是模型编出来的内容。如果要重来,Jev 还要判断是原模型重试,还是换更强的模型。修正之后,它再判断一次。判断这一步非常便宜,所以可以在循环里反复做。
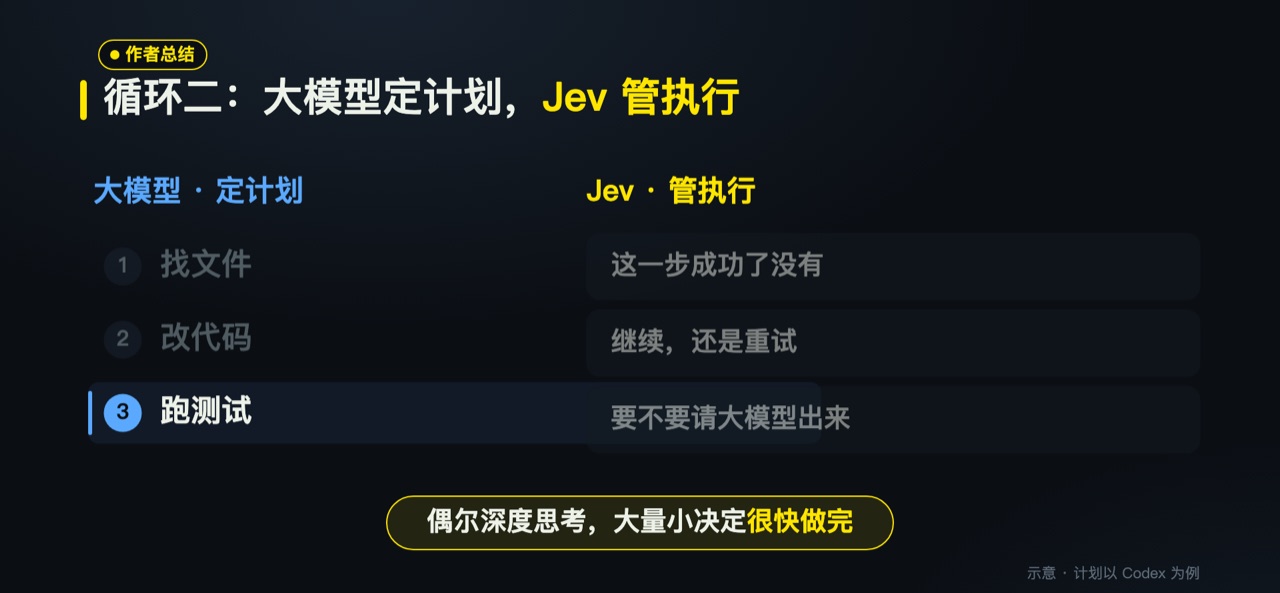
第二种循环是大模型定计划,Jev 管执行。比如写代码的 Codex 定了五步:找文件、改代码、跑测试、修 bug、提交。每一步都不用重新调用强模型。Jev 判断现在到了哪一步,成功了没有,这个错误值不值得重试。它还要决定是继续、回退、换方案,还是请大模型出来。这样 Agent 就从每一步都深度思考,变成偶尔深度思考、大量快速决定。
算力调度也可以交给它。每个请求先进 Jev,简单的给小模型,普通的给中等模型,难的给最强的模型。第二节的任务路由,测的就是这件事。甚至在一次回答内部,Jev 也能判断还值不值得再多想 5 秒。
工具调用是另一个例子。大模型说「我需要查资料」,Jev 给每个工具一个概率。比如网页搜索 0.93、文件系统 0.04、执行代码 0.02,这几个是示意数字。工具返回之后,Jev 再判断资料够不够,要不要换关键词,什么时候交回大模型。
实时审查也适合它。大模型写完一段代码,Jev 可以同时判断是否满足需求、有没有漏掉边界情况、有没有改了不该改的文件。有没有危险操作,要不要跑测试,要不要请人确认,也放在同一次请求里。这些判断是并行完成的,不用再让大模型写 500 字的 review。
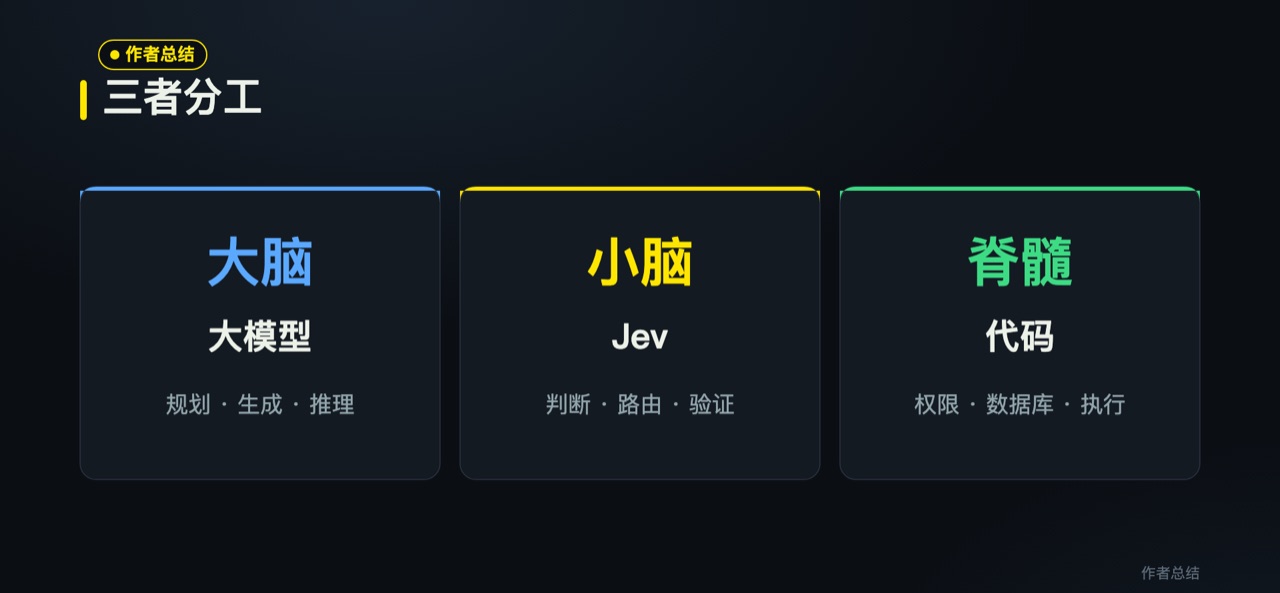
把这些放在一起,我会这样描述三者的分工:
- 大模型是大脑,负责规划、生成和复杂推理。
- Jev 是小脑,负责几百毫秒级的判断、路由、过滤、打分、停止和验证。
- 代码是脊髓,负责权限、数据库和真正的执行。
再往前推一步,下面是我的估计,不是实测。将来完成一个任务,可能是 1 次顶级大模型推理,加上 100 次 Jev 判断。它替代的,是 30 次顶级大模型的 Agent 调用。这个比例我没有数据支撑,只是按上面的分工推出来的一个方向。
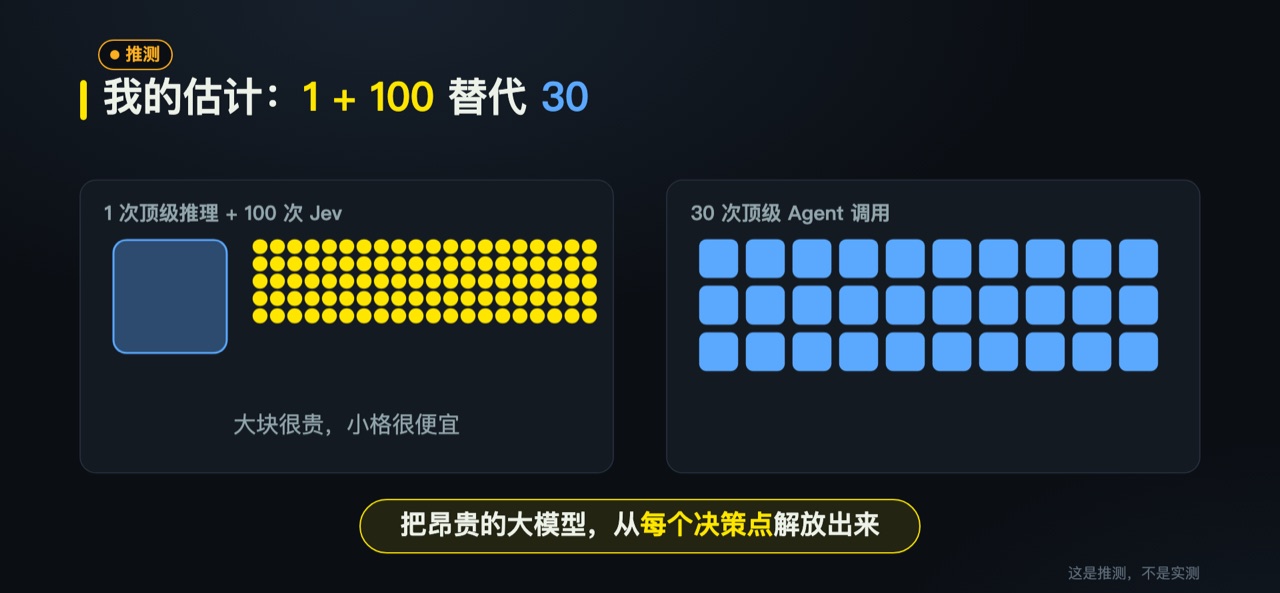
所以我觉得,Jev 最大的价值不是分类更快,而是把昂贵的大模型从每一个决策节点里解放出来。
五、它不行的地方
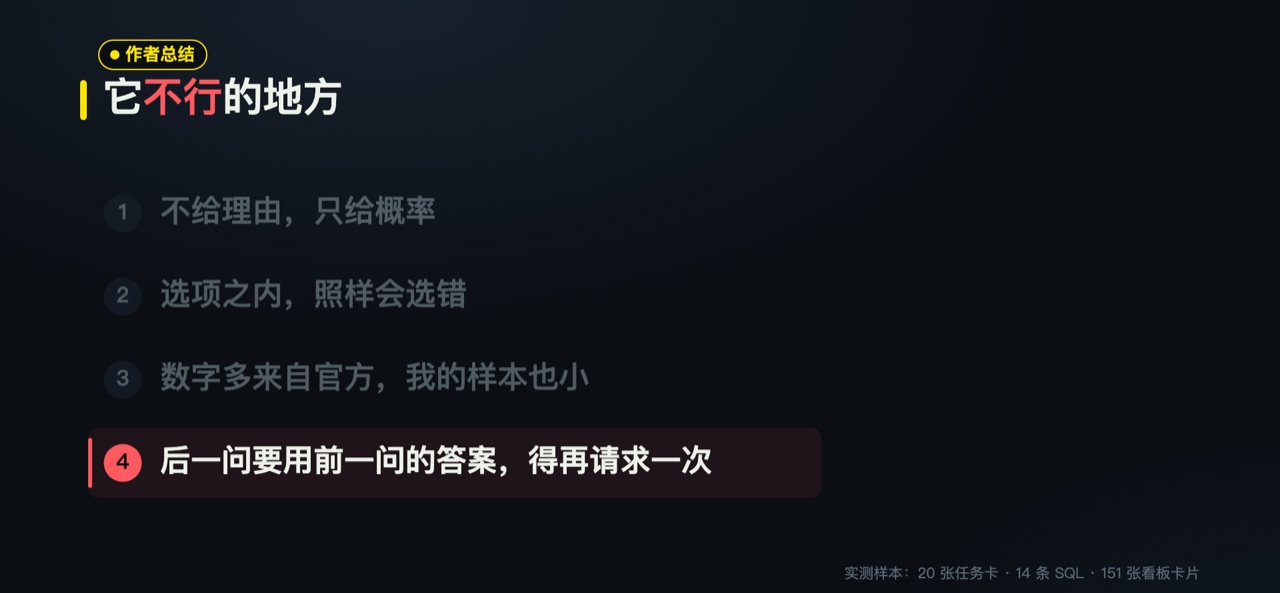
讲了这么多用法,也要把它的短处摆出来。我目前看到的有四条。
第一,它不给理由,只给概率。需要审计、要解释为什么拒绝的场景,它不够用。比如贷款审批,被拒绝的人需要知道原因,一个概率解释不了这件事。
第二,选项之内它照样会选错。SQL 实测里的 BETWEEN 就是例子,它以 0.83 的把握判断错了。所以要设阈值,把握低的交给人,或者交给大模型。返回值的类型固定,不等于结果一定可靠。
第三,数字的来源要分清。速度、价格这些数字,大多是 TypeSafe 自己公布的,还没有独立的第三方验证。我自己的实测样本也小:任务卡 20 张、SQL 14 条、看板有标签的卡 93 张。这些结果能说明方向,但说明不了它在你的数据上表现如何。
第四,它不能拿自己前一个答案接着往下判断。如果后一个问题要用到前一个问题的答案,就得再发一次请求。一次请求可以问很多个并列的问题,但问不了一串有先后依赖的问题。
六、写在最后
回到开头的问题:看板里那些判断,能不能交给 Jev?从我测的三件事看,大部分可以。选模型档位、分项目、审 SQL,都不需要大模型写一段话。Jev 半秒多一点就能给出一个可以直接分支的结果。拿不准的时候,它的把握也会低一些,这让「交给人」这一步有了依据。
它适合的位置,是大模型旁边的小脑。大模型去想难的事,Jev 管大量的小判断,代码负责真正的执行。
如果你想试,我的建议是从一个你现在正在交给大模型做的窄判断开始。先准备一份标好答案的样本,量一量准确率、漏报和成本,再决定换不换。不要一上来就把整条链路换掉。
文中的 X 插件就是 Jev Tweet Radar。日文版视频是较早的一版(八个场景),在 /ja/。