VIDEO · 2026
RAGにJevを足したら正解が7問から17問に
約 7 分の検証動画(中国語ナレーション)と記事。Jev は RAG のどの段階に入れるべきなのでしょうか。TypeSafe の公式ドキュメントで小さな RAG を組み、英語の質問 36 問を手書きして測りました。リランキング後に 1 位が正解だった問題は 7 問から 17 問に増え、ニアミス問題と無関係な質問はすべて止められました。Jev にできないことも整理しています。
中国語ナレーション · 720p · 字幕トラック(中国語) · MP4
記事:Jev を RAG の審判にする ― 1 位の正解が 7 問から 17 問に
Jev は、TypeSafe 社が 2026 年 9 月に公開した判断用のモデルです。公式には「System One モデル」と呼ばれています。テキストや JSON で状態を渡し、多肢選択・スコア付け・是非判定といった型付きの質問をいくつか添えると、各選択肢の確率を返します。文章は生成せず、判断だけを行うモデルです。
ここ 2 週間ほど、X では「Jev は RAG に向いている」という投稿をよく見かけます。RAG は、資料の中から関連する文章をいくつか探し出し、それを大規模言語モデル(LLM)に渡して回答させる、よく使われる手法です。「Jev が RAG の精度問題を解決した」という声もありますが、データを示している投稿はあまりありません。私が知りたかったのは、もっと具体的なことです。Jev は RAG のどの段階に入れるべきなのか。
そこで、TypeSafe 自身の公式ドキュメントを使って小さな RAG を組み、質問を手書きして測ってみました。この記事では、まず RAG がなぜ間違えるのかを説明し、X での意見を整理します。次に実験の方法・条件・結果を示し、最後に Jev をどこに置くべきか、そして Jev にできないことをまとめます。
1. RAG はなぜ間違えるのか
RAG には二つの役割があります。検索は、資料の中から質問に関連する文章を数段落探し出します。LLM はそれを読んで回答を書きます。検索は通常、類似度の順に並べます。一つは字面で比べる方法で、質問と段落に共通する単語の数を数えます。もう一つはベクトル検索です。各段落を数値の列に変換し、その近さを比べるので、言い回しが違う文でも見つけられます。
ただし、似ていることと答えられることは別です。たとえば「返品は何日以内ですか?」と聞かれたとします。検索は、返品ポリシー、返品手続きの説明、忘年会のお知らせの 3 段落を返すかもしれません。日数が書かれているのは返品ポリシーだけです。返品手続きの説明は送り返し方の話で、よく似ていますが日数はありません。忘年会のお知らせは、たまたま同じ単語が含まれていただけで、やはり答えはありません。
LLM は、この 3 段落のどれに本当に答えがあるのかを知りません。答えの書かれた段落がそもそも検索に引っかからなかった場合、手元の無関係な段落をもとに、もっともらしい回答をでっち上げてしまうことがよくあります。この種の間違いは、素直に「分かりません」と言うより厄介です。読む側が気づきにくいからです。
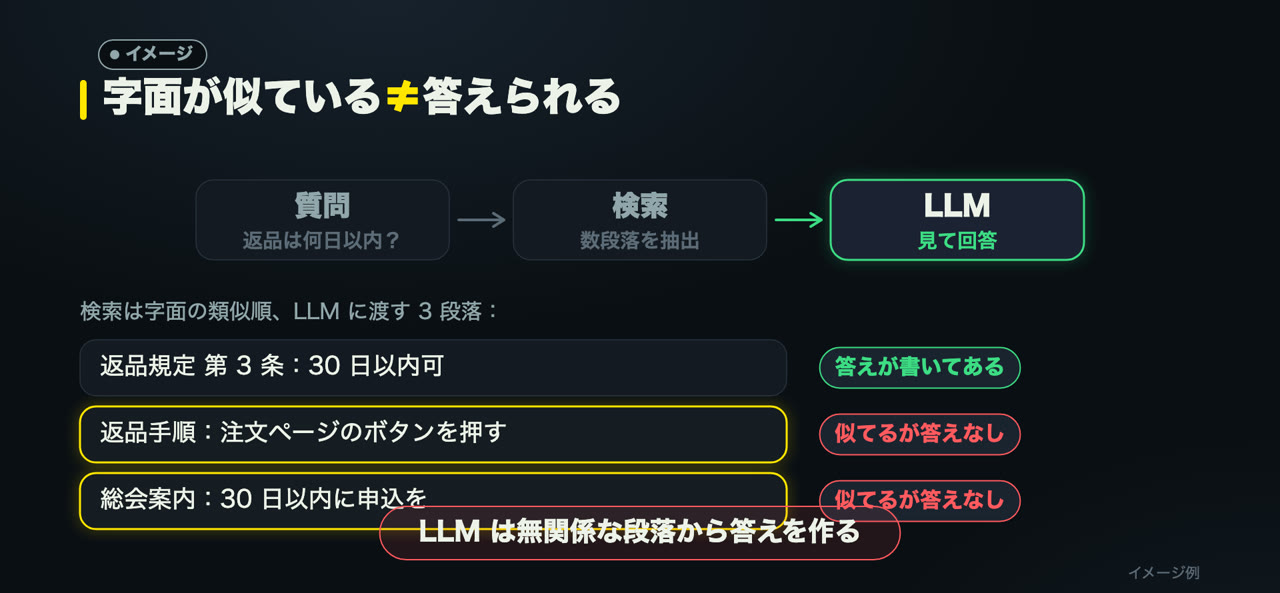
つまり、RAG の間違いは大きく二種類に分けられます。一つは検索が間違った資料を拾うケースで、答えの段落の順位が低すぎるか、そもそも見つかっていません。もう一つは資料にそもそも答えがないのに、LLM が無理に答えるケースです。このあとの実験では、この二種類の間違いに対して Jev が何をできるかを、それぞれ確かめます。
2. X での主な意見
9 月の中旬から下旬にかけて、X には「Jev で RAG」という投稿がまとまって出てきました。代表的なものを三つ選びました。いいね数などは、すべて 9 月 27 日に私が取得した値です。
最もいいねが多かったのは、Kush さんが 9 月 17 日に投稿したもので、2027 いいね、11.5 万回表示でした。内容は「Jev が RAG の精度を解決した。各段落にスコアを付け、無関係なものを削ればよい」というものです。考え方自体は妥当ですが、投稿には実験データが一切ありません。
二つ目は、LangChain のエンジニアである Viv さんが 9 月 23 日に投稿したもので、748 いいね、12.9 万回表示、946 ブックマークでした。LangChain は、RAG を組むのに広く使われているオープンソースのフレームワークです。Viv さんの提案は、資料の量で二つに分かれます。資料が少ないなら、(質問, 文書)の組ごとに Jev でスコアを付け、それを関連度として使う。ベクトルデータベースすら要らない、というものです。
資料が多い場合は、まず BM25 かベクトル検索で候補をまとめて取り、そのあと Jev でリランキングする、という提案です。BM25 は昔からあるキーワード検索で、質問と段落に共通する単語を見て、珍しい単語ほど重く数えます。リランキング(再順位付け)とは、安い方法で候補をまとめて集めてから、より正確な方法でその候補を並べ直すことです。返信欄では、Jev が一度に扱える選択肢の数には上限があるので、候補を無制限には増やせない、という指摘もありました。
三つ目は、9 月 20 日に公開された技術ブログの検証記事で、jev-1.13.0 を使っています。筆者は架空の社内規程を作って 400 段落に分けました。このブログの実験では、ベクトル検索の時点ですでに答えが上位 5 件に入っていたため、各社のリランキングの精度にはほとんど差が出ませんでした。筆者自身も、コーパスが小さすぎたと認めています。
はっきり差がついたのは、別の点でした。「この段落で質問に答えられるか」です。このブログは、話題は合っているのに答えが書かれていない質問で比較しています。この種の質問で、Jev の判定の正答率は 99.2% でした。Cohere もリランキングモデルを提供している会社ですが、同社の Rerank 3.5 でスコアにしきい値を引いた場合の正答率は 65% にとどまりました。コストは、このブログの測定で Jev が 1000 回あたり 0.25 ドル、Cohere が 1000 回あたり 2.00 ドルです。
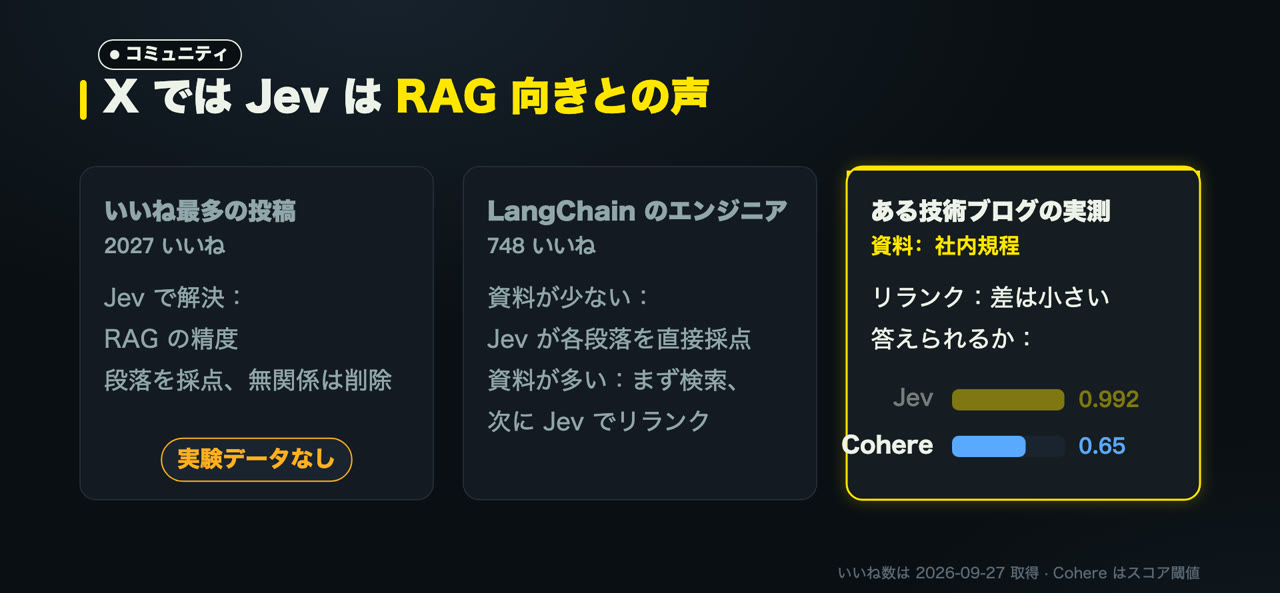
三つを並べると、Kush さんが示したのは直感、Viv さんが示したのは置き場所、ブログが示したのはデータです。ただしブログのコーパスは小さすぎました。そこで自分でも一度測ってみることにしました。その際、「リランキング」と「答えられるかどうか」を分けて見たいと考えました。
3. 検証の方法
実験を行ったのは 2026 年 9 月 27 日、モデルのバージョンは jev-1.13.0 です。コードと結果は GitHub に置いています:github.com/DDnim/jev-rag-bench。
資料には TypeSafe 自身の公式ドキュメント 42 ページを使いました。第 2 レベルの小見出しごとに区切って 258 段落に分け、コードブロックは除いています。このドキュメントを選んだのは、公開されていて誰でも再現できるからです。
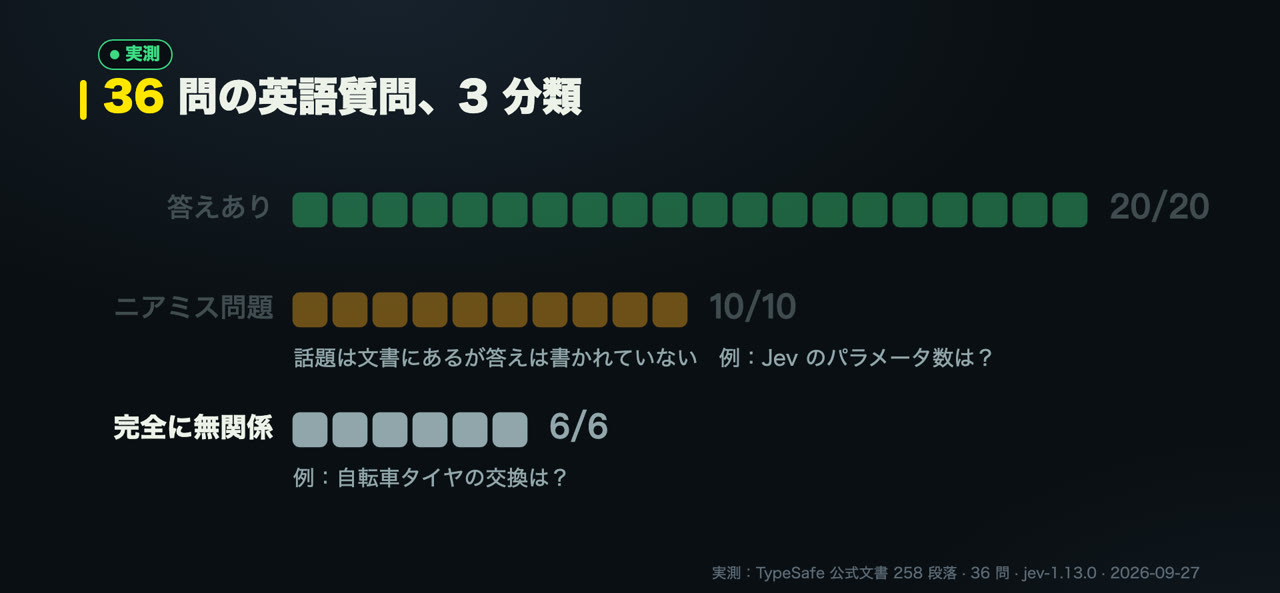
質問は私が手書きした英語の 36 問で、次の 3 種類に分かれます。
- 答えのある質問 20 問。ドキュメントに答えが書かれており、どの段落が答えかを 1 問ずつラベル付けしました。
- ニアミス問題 10 問。話題はドキュメントに出てくるものの、答えは書かれていません。
- まったく無関係な質問 6 問。たとえば自転車のタイヤの交換方法や、オーストラリアの首都はどこか、といったものです。
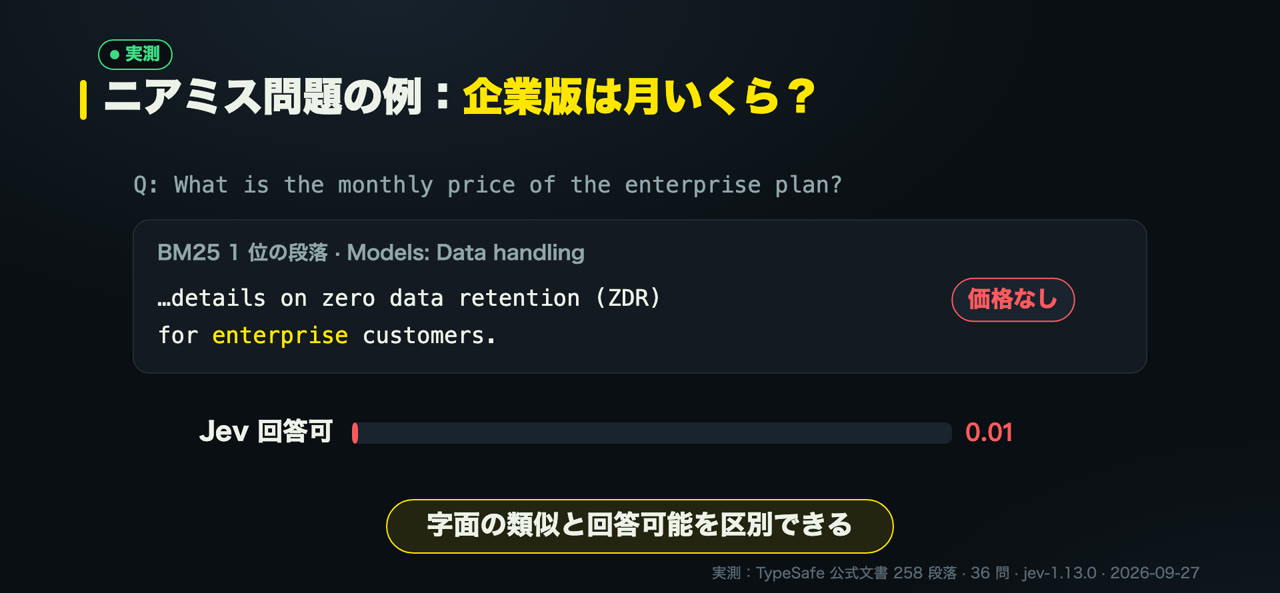
「ニアミス問題」は借りてきた言葉で、あと少しで答えられそうに見えて、実は答えられない質問を指します。私が書いたのは、Jev のパラメータ数、どの GPU で動いているか、エンタープライズ版の月額料金、MMLU というベンチマークのスコア、創業者は誰か、といった質問です。この種の質問は最も危険です。検索はよく似た段落を必ず見つけてくるので、LLM が無理に答えるよう誘導されやすいからです。
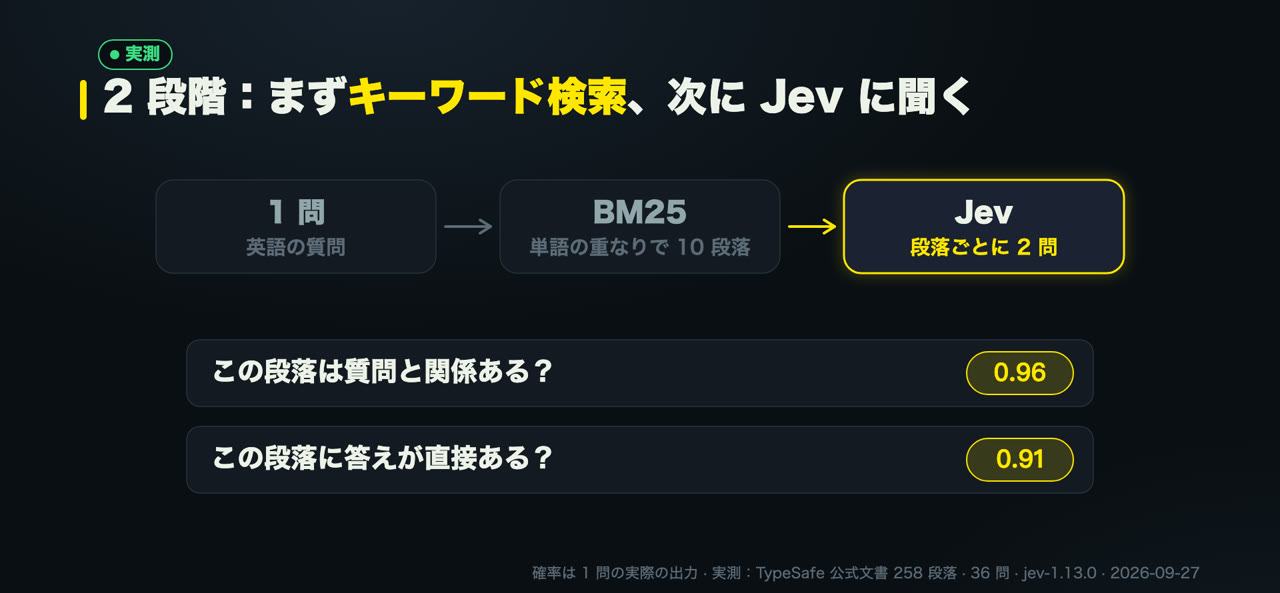
最初の段階は検索です。BM25 で各質問の上位 10 段落を取りました。BM25 を選んだのは、単純で中身が分かりやすく、しかも比較的弱いからです。弱い検索なら、Jev がどれだけ助けになるかを見る余地が残ります。
次の段階は判定です。質問と各段落を組にして Jev に送りました。1 問あたり 10 リクエストで、4 並列です。各リクエストでは、次の二つの是非判定を聞いています。
この段落は質問と関係があるか? この段落に答えが直接書かれているか?
Jev は、それぞれの是非判定について「はい」の確率を返します。以降のリランキング、フィルタリング、答えられるかどうかの判定には、すべて二つ目の「答えが書かれている」確率を使いました。一つ目の結果も記録はしましたが、判断には使っていません。
4. リランキング:1 位が正解の問題が 7 問から 17 問に
まずはリランキングです。見たのは、答えのある 20 問で、1 位の段落が答えになっているかどうかです。私の測定では、BM25 だけの場合は 7 問でした。Jev の「答えが書かれている」確率で並べ直すと、17 問になりました。
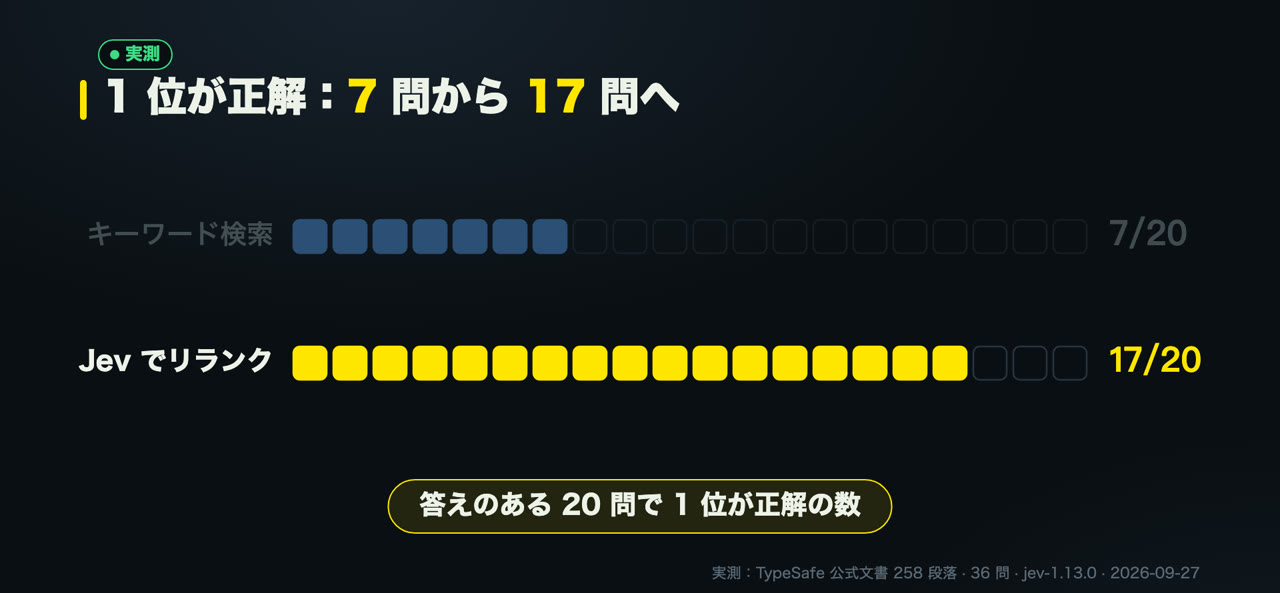
もう少し詳しく見ます。私の測定では、BM25 だけの場合、答えが上位 3 件に入っていたのは 11 問、上位 10 件に入っていたのは 17 問でした。Jev でリランキングすると、1 位が答えだったのが 17 問、上位 3 件でも 17 問です。
この 17 という数が上限です。残りの 3 問では、BM25 が上位 10 段落の中に答えを見つけられておらず、Jev には並べ直す答えがありませんでした。言い換えると、答えが候補に入ってさえいれば、Jev は毎回それを 1 位にしました。
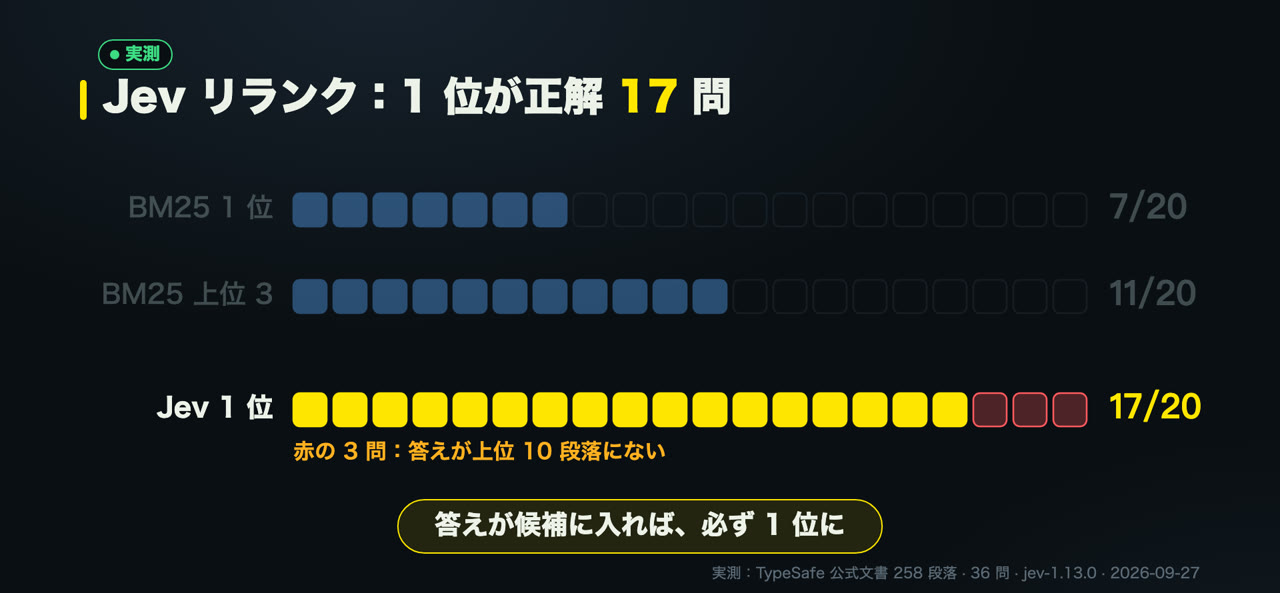
ここで、途中で修正した点を書いておきます。1 回目の実行のあと、Jev が 1 位にした段落のうち 3 問分は、実は質問に答えていたのに、私がラベルを付け忘れていたことに気づきました。そこでこの 3 段落を正解に追加しています。修正前の基準では、私の測定で Jev の 1 位正解は 14 問、BM25 は同じく 7 問でした。
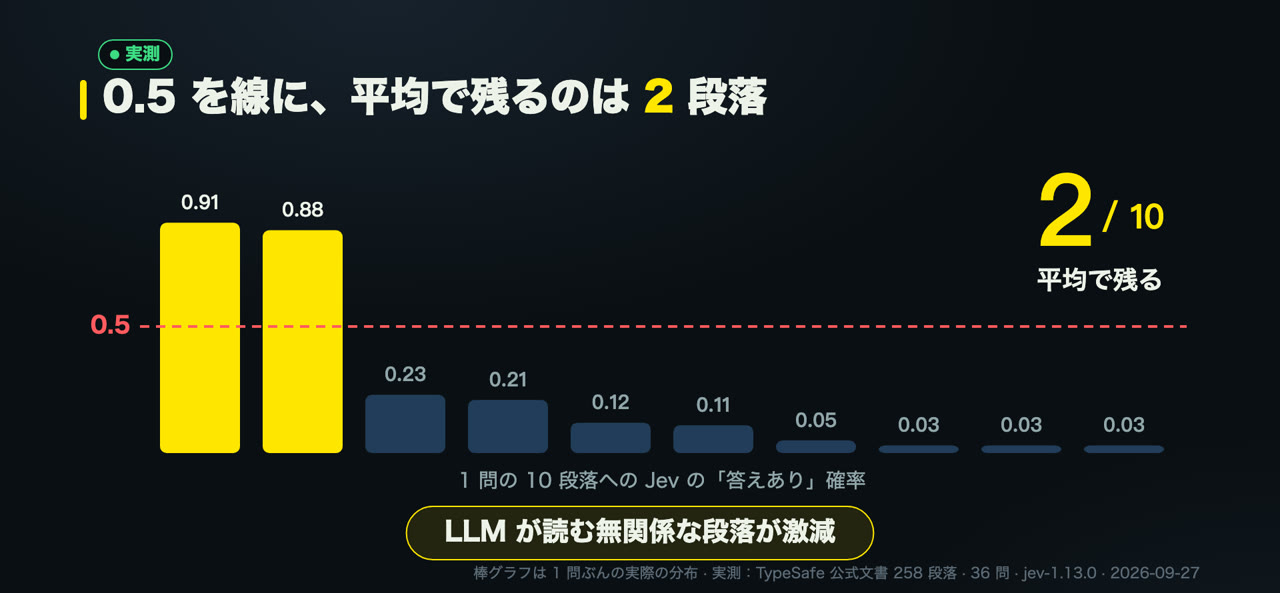
続いてフィルタリングです。ここではしきい値を使います。しきい値とはスコアの境界線のことで、それを超えたものだけを採用します。今回は 0.5 に設定し、「答えが書かれている」確率が 0.5 を超えた段落だけを残して、ほかは捨てました。
私の測定では、答えのある質問 1 問あたり、10 段落のうち平均 2 段落しか残りませんでした。残りの段落は LLM に渡さずに済みます。LLM が読む無関係な段落が減れば、無関係な内容をもとに答えをでっち上げる機会も減ります。
リランキングでこれだけ差がついたのは、BM25 のせいでもあります。BM25 は比較的弱い検索なので、よいベクトル検索に替えれば、リランキングでつく差は小さくなります。先のブログで各社にほとんど差が出なかったのも、そのためです。したがって、この節の数字から言えるのは「Jev は答えを選び出せる」ということまでです。「Jev に替えればこれだけ正解が増える」とは言えません。
5. 答えられるかどうかの判定
この節がいちばん伝えたかった内容です。リランキングが扱うのは「答えが何位にあるか」ですが、もっと重要な問題があります。そもそも候補の中に答えがあるのかどうかです。答えがないなら、LLM にでっち上げさせるのではなく、システムが直接「ドキュメントに記載がありません」と返すのが最善です。
判定ルールは単純です。1 問の 10 段落のうち、「答えが書かれている」確率が 0.5 を超える段落が一つでもあれば、答えられると判断します。一つもなければ LLM を呼ばず、「ドキュメントに記載がありません」とそのまま返します。擬似コードにすると次のとおりです。
probs = [jev_answers(question, p) for p in top10]
if max(probs) > 0.5:
    ask_llm(question, [p for p in top10 if prob(p) > 0.5])
else:
    reply("ドキュメントに記載がありません")
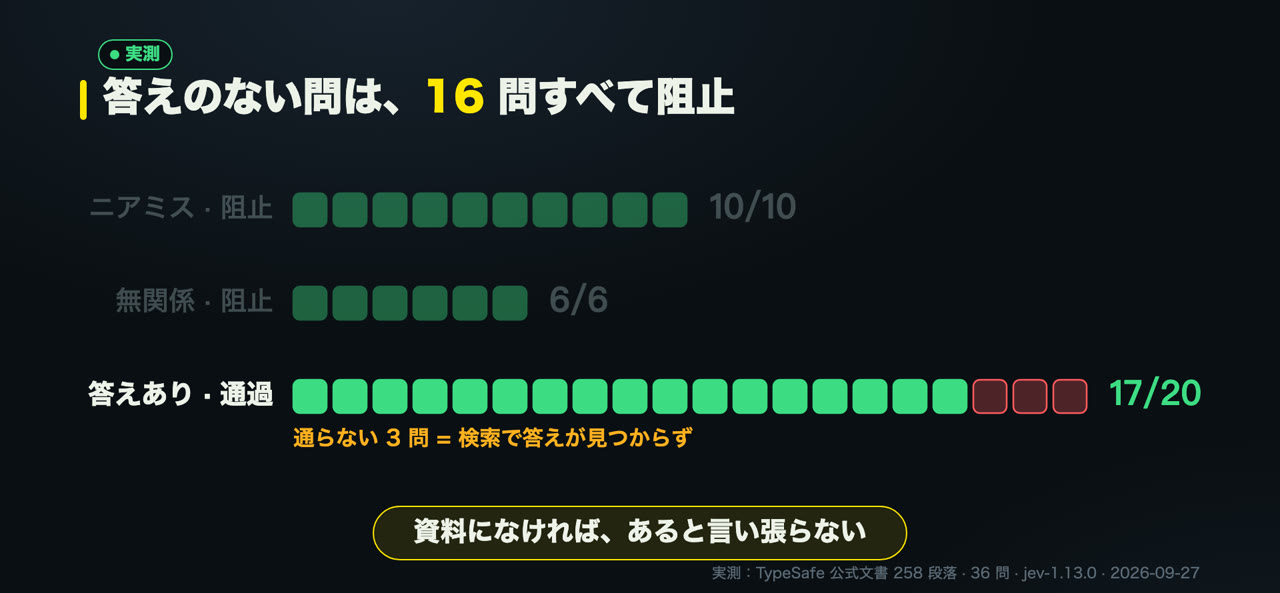
結果です。私の測定では、ニアミス問題 10 問はすべて Jev が「答えられない」と判定し、10/10 で止められました。まったく無関係な質問 6 問も、6/6 ですべて止めています。答えのある 20 問のうち、通したのは 17 問でした。
通らなかった 3 問は、ちょうど BM25 が答えを見つけられなかった 3 問です。この 3 問の候補には本当に答えがなく、Jev は無理に「答えられる」とは言いませんでした。システム全体で見れば、この 3 問に「ドキュメントに記載がありません」と返すのはむしろ正しい振る舞いです。LLM に渡しても、でっち上げるしかないからです。
ニアミス問題の例を一つ挙げます。質問は「What is the monthly price of the enterprise plan?」、つまりエンタープライズ版の月額料金です。BM25 が 1 位にしたのは、エンタープライズ顧客のデータ保持について書かれた段落で、末尾に「zero data retention (ZDR) for enterprise customers」とあります。ZDR はゼロデータ保持のことで、サービス側が顧客のデータを保存しないことを指します。
この段落には enterprise という単語があり、質問との字面の重なりが大きいので、BM25 は 1 位にしました。しかし料金はどこにも書かれていません。私の測定では、Jev がこの段落に付けた「答えが書かれている」確率は 0.01 でした。この段落を LLM に渡していたら、文脈から料金をでっち上げていた可能性が高いでしょう。
では、BM25 だけで同じ判定はできるのでしょうか。これも試しました。各質問の BM25 の最高スコアにしきい値を引き、それを超えれば答えられる、下回れば答えられない、と判定する方法です。36 問すべてであらゆるしきい値を試し、結果が最もよかったものを選びました。これは BM25 に有利なやり方です。実際の運用では、どのしきい値が最適かを事前に知る方法はないからです。
それでも私の測定では、BM25 が正しく判定できたのは 36 問中 30 問でした。Jev は、しきい値を選び直すことなく固定の 0.5 で 33 問を正しく判定しています。36 問のうち、Jev は 33 問、最適なしきい値を選んだ BM25 は 30 問を正しく判定しました。
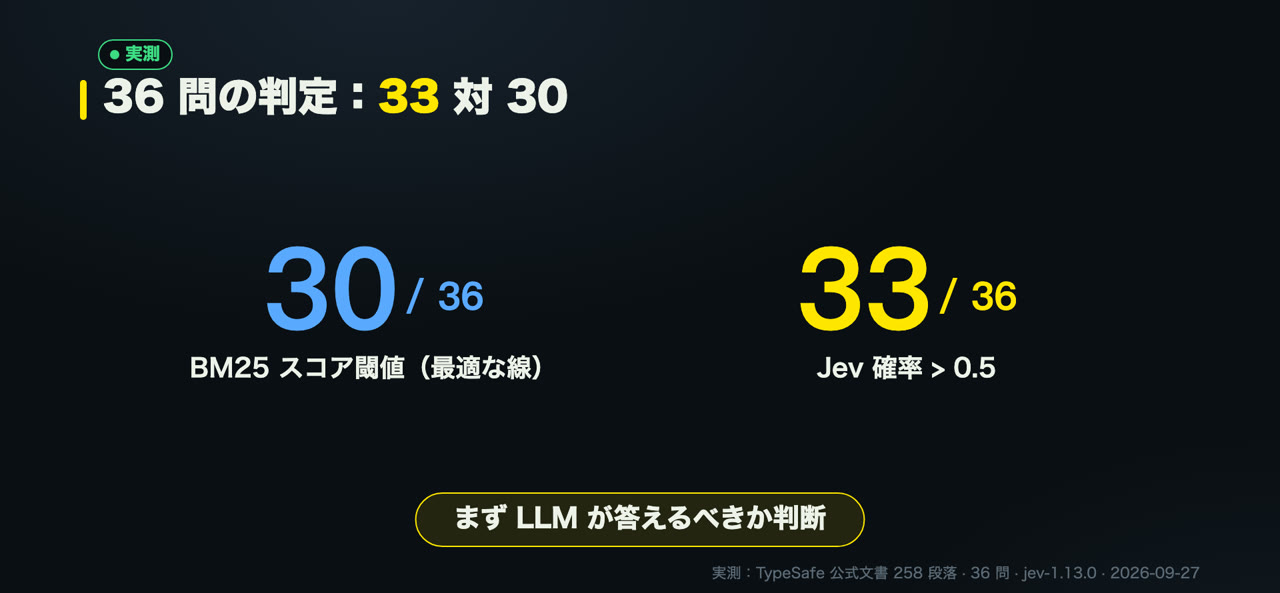
理由は想像がつきます。BM25 のスコアが測っているのは単語の重なりです。ニアミス問題はまさに、単語の重なりは大きいのに答えがない種類の質問です。類似度スコアでは「この段落に答えが書かれているか」は分かりません。Jev が聞かれているのは、まさにその問いです。これは先のブログの結果とも同じ方向です。話題は合っているのに答えが書かれていない質問で、ブログの測定では Jev が 99.2%、スコアにしきい値を引いた Cohere が 65% でした。
4 節と 5 節の結果をまとめると、次のとおりです。
| 指標(私の測定) | BM25 | Jev |
|---|---|---|
| 答えのある 20 問で、1 位が答え | 7 問 | 17 問 |
| 答えのある 20 問で、答えが上位 3 件に入る | 11 問 | 17 問 |
| 36 問で、答えられるかどうかを正しく判定 | 30 問(最適なしきい値を選択) | 33 問 |
6. コストと、Jev を置く場所
まずコストです。モデルはトークン単位で課金されます。トークンとは、モデルが文章を読むときに切り分ける小さな単位で、1 単語が 1 トークンのこともあれば、数トークンになることもあります。公式の料金は入力 100 万トークンあたり 0.042 ドルで、出力は無料です。
私の測定では、実験全体のリクエストは 360 回、1 回あたりの入力は平均 554 トークンでした。総費用は 0.0084 ドルで、1 問あたり約 0.00023 ドル、1000 問に換算すると約 0.23 ドルです。1 リクエストのレイテンシは中央値が 223 ミリ秒で、90% のリクエストが 303 ミリ秒以内に返りました。条件は 4 並列です。
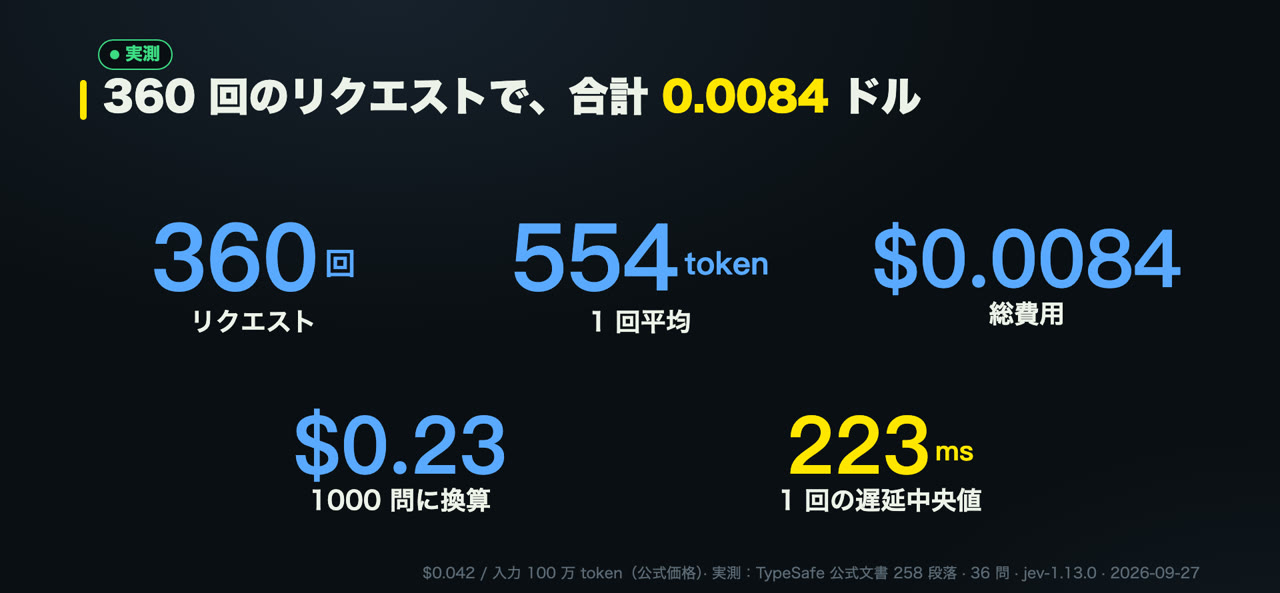
ブログの「1000 回あたり 0.25 ドル」はリクエスト単位、私の「1000 問あたり 0.23 ドル」は質問単位で、1 問につき 10 リクエストです。単位が違うので、そのまま比べることはできません。ただ、どちらで数えても、この判定層のコストはかなり低いと言えます。
次に置き場所です。TypeSafe は、RAG での Jev の使い方を解説した cookbook をいくつか公開しています。cookbook とは公式のレシピ集のようなもので、1 本ごとに一つの使い方を、動くコード付きで紹介しています。
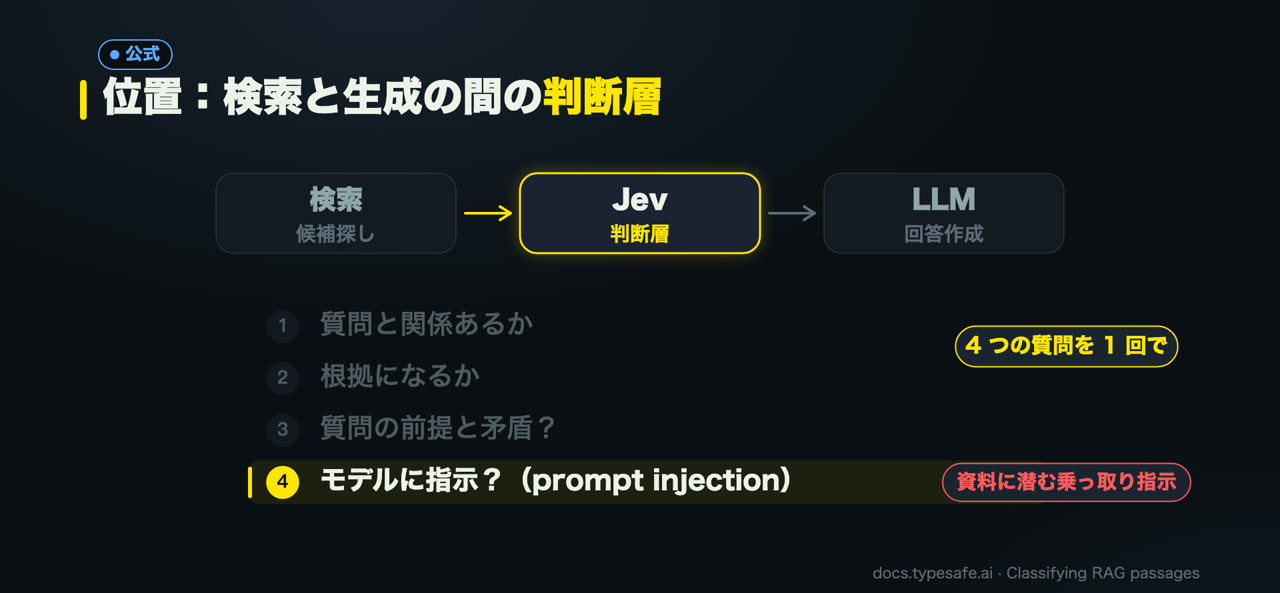
1 本目は「Classifying RAG passages」です。Jev を検索の後、生成の前に置き、各段落について四つの是非判定を聞きます。
- この段落は質問と関係があるか。
- この段落は根拠として使えるか。
- この段落は質問の前提と矛盾しているか。
- この段落はモデルに指示を出そうとしているか。
最後の問いはプロンプトインジェクション対策です。プロンプトインジェクションとは、資料の中に指示を紛れ込ませ、その資料を読んだ LLM を乗っ取ろうとする攻撃です。公式のやり方では、四つの問いを 1 回のリクエストで聞きます。しきい値はコードに書いておき、その段落を根拠として使うか、矛盾する情報として扱うか、捨てるかをコード側で決めます。
2 本目は「Re-ranking」です。公式のやり方では、まず BM25 で 30 段落の候補リストを取り、そのあと Jev で(質問, 候補)の組ごとにスコアを付けて並べ直します。40 問の法律関係の質問で示されたデモでは、top-1 が 5% から 18% に、top-10 が 38% から 62% に上がりました。公式自身も、サンプルが小さく、これはレシピのデモであって評価ではないと述べています。
3 本目は「Double-checking citations」で、生成の後に置きます。LLM が回答を書き、各文に出典を付けます。Jev は引用された段落と文を 1 組ずつ見て、その出典が主張を支えているかを判定します。
規模については、結論は Viv さんの意見とほぼ同じです。資料が少なければ、ベクトルデータベースを使わず、Jev で各段落にスコアを付ければ十分です。資料が多ければ、BM25 かベクトル検索で上位数十段落を取り、それを Jev に渡してリランキングとフィルタリングをします。
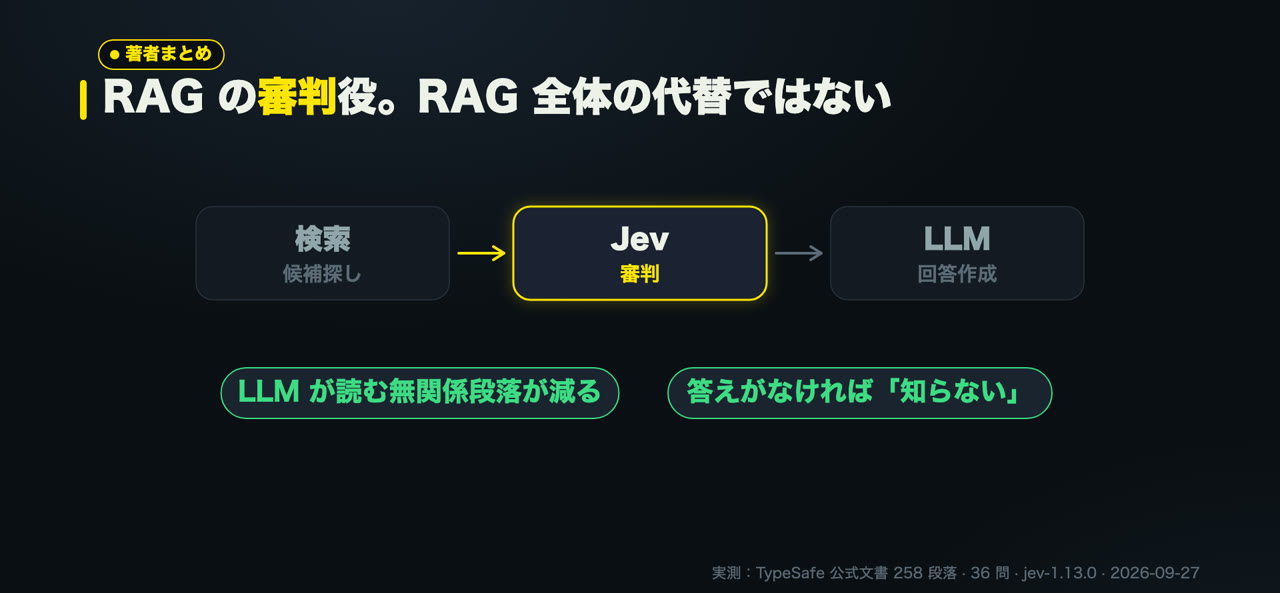
私の考えでは、Jev は RAG の「審判」、つまり判定層として使うのに向いています。RAG 全体を置き換えるものではありません。いちばん価値があるのは、LLM が話し始める前に、そもそも話すべきかどうかを判断するところです。
7. Jev にできないこと
できることを書いたので、できないことも明らかにしておきます。5 点にまとめました。
- Jev は答えを書かない。最終的な回答は LLM に任せる必要がある。
- 検索が取りこぼした答えは、Jev には取り戻せない。
- 資料全体を一度に Jev に渡すことはできない。1 リクエストにはトークンの上限がある。
- Jev は英語で最も正確。中国語などは、まず自分のデータで測る必要がある。
- 私の実験はサンプルが小さく、結論をそのまま読者のコーパスに当てはめることはできない。
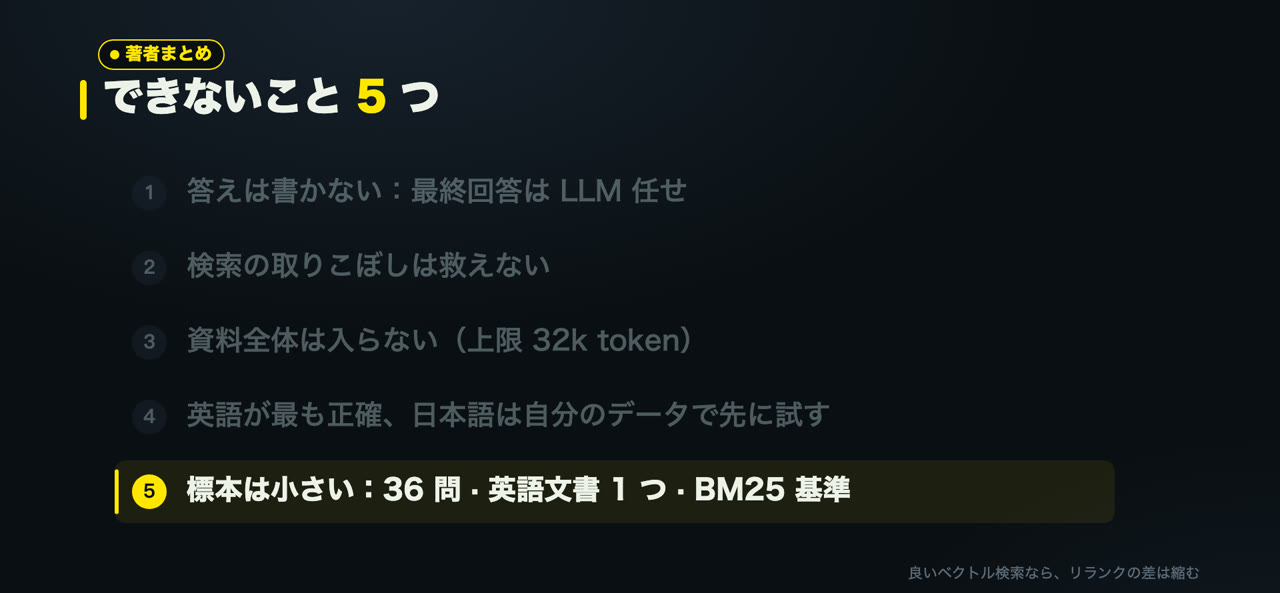
1 点目は公式に明記されています。Jev は文章を生成しません。どの段落に答えがあるか、答えるべきかどうかは教えてくれますが、回答を書くのは LLM です。
2 点目は、先ほどの 3 問がまさにその例です。BM25 が上位 10 段落に答えを入れられなければ、Jev がどれだけ正確でも「答えられない」と言うことしかできません。無理に答えないことは保証できても、答えを生み出すことはできません。取りこぼしを減らすのは、あくまで検索側の仕事です。
3 点目には二つの理由があります。公式によると、1 リクエストの状態と最も長い質問を合わせた上限は 32k トークン、リクエスト全体では 64k トークンで、受け付けるのはテキストだけです。さらに公式の jaggedness ドキュメントには、状態に含まれる無関係な内容が多いほど精度が下がるので、先にコード側で検索と絞り込みをするべきだと書かれています。つまり「資料全体を Jev に投げて選ばせる」というやり方は成り立ちません。
4 点目も公式の説明によるものです。英語が最も正確で、中国語などほかの言語も使えますが、英語ほどではありません。私の実験は英語のドキュメントと英語の質問だけで行っています。資料が中国語なら、まず自分のデータで一度測ってから導入を判断してください。
5 点目は私自身の実験の限界です。36 問も正解ラベルも私が作ったもので、ドキュメントは英語の 1 種類だけ、検索には比較的弱い BM25 を使っています。1 回目の実行のあとに、3 問分の正解ラベルを追加してもいます。話題になった投稿の「精度を解決した」といった主張も、そのまま自分のコーパスでの結果だと受け取らないほうがよいでしょう。
8. おわりに
冒頭の問いに戻ります。Jev は RAG のどの段階に入れるべきか。私の答えは、検索の後、生成の前に「審判」として置くことです。資料を探すのでも回答を書くのでもなく、各段落に答えが書かれているか、その質問にそもそも答えられるかを判定する役です。
私の小さな実験では、Jev は二つの点で役に立ちました。一つは答えを 1 位に並べ直すことで、ただし答えがすでに候補に入っていることが前提です。もう一つは、資料に答えがないときに LLM を止めることで、ニアミス問題と無関係な質問はすべて止められました。私は二つ目のほうが価値が大きいと考えています。無理に答えた間違いは、いちばん気づきにくいからです。
試してみるなら、「答えられるかどうか」の判定から始めることをおすすめします。今の検索には手を入れず、検索と LLM の間に判定を 1 回挟むだけです。候補の中に答えが書かれた段落が一つもなければ、「ドキュメントに記載がありません」とそのまま返します。まず自分のデータで一度動かし、止めるべき質問をどれだけ止められたか、止めなくてよい質問をどれだけ誤って止めたかを見てください。ここがうまく動いたら、リランキングとフィルタリングを検討すればよいと思います。
最後に一つ聞かせてください。みなさんの RAG でいちばん多い間違いは、資料の拾い間違いでしょうか。それとも、資料に答えがないのに無理に答えてしまうことでしょうか。よければ X などで教えてください。私のコードを自分のコーパスで動かした結果も、ぜひ聞かせてください。
参考: TypeSafe 公式ドキュメント:docs.typesafe.ai(Models、Classifying RAG passages、Re-ranking、Double-checking citations、Jev 1.13 jaggedness)
実験のコードと結果:github.com/DDnim/jev-rag-bench
動画は bilibili にも公開しています。シリーズ:Jev01 · Jev02 · Jev03 · Jev04 · Jev vs Laya。